

Граница задачи и модель доверия
В наших внедрениях я начинаю не с импорта большого шаблона, а с перечня портов, за которые действительно отвечает эксплуатация. У каждого такого интерфейса есть назначение, ожидаемое административное состояние, допустимый режим работы и владелец решения об отключении. Это сразу отделяет отказ линии от согласованного shutdown. Если ifAdminStatus показывает down, мониторинг обязан учитывать операторский контекст: административно выключенный резервный, свободный или обслуживаемый порт сам по себе не является неисправностью. Когда ifAdminStatus остаётся up, а ifOperStatus устойчиво переходит в down, появляется основание проверять физический канал, соседнее оборудование и согласованное окно работ. Имена ifName и описания ifAlias я использую как операционную привязку, но не как безусловно уникальный идентификатор: их способны изменить администраторы. Перед внедрением фиксирую, какие роли разрешены, кто поддерживает подписи и как обрабатывается переименование. Такой договор важнее красивой карты. Он не даёт временному интерфейсу превратиться в объект круглосуточной аварийной реакции и запрещает считать любой зелёный статус доказательством исправности сервиса поверх сети. Область мониторинга остаётся узкой: состояние, нагрузка и качество выбранных интерфейсов, свежесть данных и безопасность чтения. Маршрутизацию, прикладную доступность и корректность политики коммутации подтверждают отдельные проверки. Я сохраняю анонимность рабочего контура и не переношу в статью адреса, названия узлов или фактические идентификаторы оборудования.
SNMPv3 без ослабления после перезагрузки
Для опроса я применяю SNMPv3 USM user с уровнем authPriv: сообщение аутентифицируется и защищается шифрованием. authProtocol и privacyProtocol задаются явно из совместимого набора, разрешённого политикой безопасности и реализацией устройства. Пароли, локализованные authentication keys и privacy keys не оказываются в шаблоне, командной строке, примере кода или URL. У каждого SNMP engine должен быть уникальный engine ID. Менеджер обнаруживает его, локализует ключевой материал для данного engine и кэширует параметры авторитетного источника. После замены устройства или изменения идентичности кэш следует проверить и при необходимости безопасно обновить, иначе корректные запросы могут отвергаться. Перезагрузка имеет отдельную механику. USM использует snmpEngineBoots и snmpEngineTime, чтобы контролировать временное окно и защищаться от повторного воспроизведения сообщений. Поэтому после reboot я проверяю доступные объекты SNMP-FRAMEWORK-MIB, время запуска, журнал самого средства сбора и повторное discovery/caching engine-параметров. Сброс времени или увеличение boots объясняет разрыв сессии и счётчиков, но не требует заново передавать пароль и тем более не оправдывает переход на noAuthNoPriv либо SNMPv2c. Если синхронизация не восстановилась, исследую уникальность engine ID, состояние постоянного хранилища агента, кэш менеджера и совместимость протоколов. Защита остаётся прежней; исправляется состояние доверенной сессии, а не её класс безопасности.
Ограниченная область чтения на устройстве
Минимальные привилегии я реализую на стороне устройства, а не только обещанием не запрашивать лишнее. Для отдельного пользователя создаётся VACM view только для нужных объектов IF-MIB и тех объектов SNMP-FRAMEWORK-MIB, которые требуются для безопасной диагностики engine. Представление выдаётся в режиме read-only; операции записи и остальные ветви дерева недоступны. Если конкретная платформа умеет связывать доступ с источником, разрешаю запросы лишь от адреса Zabbix server или уполномоченного proxy. Это дополняет authPriv, но не заменяет сетевую фильтрацию и управление ключами. Перед изменением сохраняю резервную копию конфигурации и проверяю, что существует рабочая процедура восстановления. В публичном описании достаточно модели прав: я не привожу полный синтаксис устройства, реальный engine ID, имя боевого пользователя, адрес менеджера или криптографический материал. В Zabbix создаю именованный SNMPv3 interface, чтобы назначение соединения было видно без раскрытия секрета. Чувствительные значения размещаются в encrypted macros с ограниченным доступом; обычный текстовый макрос для них неприемлем. Элементы создаются с официальным типом SNMP agent и конкретными OID, а не с вымышленным или generic agent key. После настройки подтверждаю чтение только разрешённых листьев и ожидаемый отказ обращения за пределы view. Последний тест важен: успешный IF-MIB poll ещё не доказывает, что учётной записи действительно запрещено читать лишнее.
Состояние, скорость и непрерывность счётчиков
Основную пару состояния составляют ifAdminStatus и ifOperStatus. Первое значение отражает административное намерение, второе — фактическую готовность нижнего уровня; выражение проблемы учитывает оба и политику конкретного порта. Для пропускной способности я предпочитаю 64-битные ifHCInOctets .1.3.6.1.2.1.31.1.1.1.6 и ifHCOutOctets .1.3.6.1.2.1.31.1.1.1.10 там, где устройство их корректно поддерживает. На быстрых линиях 32-битный октетный счётчик способен обернуться между опросами, создав ложный спад или неверную скорость. Однако сам размер не решает вопрос непрерывности. Скорость вычисляется из delta двух последовательных значений за фактическое прошедшее время; отрицательный или неправдоподобный delta нельзя автоматически превращать в трафик. Я сверяю ifCounterDiscontinuityTime: его изменение обозначает переинициализацию счётчиков и требует начать новый ряд без склейки с предыдущим. Перезагрузка и смена ifIndex также разрывают историю. ifHighSpeed задаёт полезный контекст номинальной скорости и помогает оценивать правдоподобие вычисленного rate, но это не универсальный порог загрузки. Выбор 32 или 64 бит определяется поддержкой агента, скоростью интерфейса, периодом опроса и риском wrap. Если доступны надёжные высокоёмкие счётчики, брать младший вариант ради совместимости неразумно. Если HC-объекты отсутствуют, ограничение явно документируется, а интервал и обработка оборачивания выбираются для конкретного порта, без обещания абсолютной точности.
Ошибки, потери и обнаружение подходящих портов
К объёму трафика я добавляю ifInErrors .1.3.6.1.2.1.2.2.1.14, ifOutErrors .1.3.6.1.2.1.2.2.1.20, ifInDiscards .1.3.6.1.2.1.2.2.1.13 и ifOutDiscards .1.3.6.1.2.1.2.2.1.19. Errors говорят о пакетах, которые не удалось корректно обработать из-за ошибок, а discards могут расти при отбрасывании без физического повреждения, например из-за очередей или политики. Их rate также строится из delta с учётом ifCounterDiscontinuityTime. Единого числа, после которого порт объявляется плохим, я не задаю: смысл зависит от скорости, роли, объёма трафика и поведения оборудования. Состав объектов определяет LLD. Я не обнаруживаю всё дерево интерфейсов с одинаковыми прототипами. Фильтр и override используют ifName, ifAlias, ifType и операционную политику, чтобы включить физические и логические порты, за которыми действительно наблюдают. Loopback, служебные virtual, автоматически возникающие tunnel, временные и transient интерфейсы исключаются, если у них нет отдельного согласованного назначения. При этом один лишь ifType недостаточен: производитель может представить агрегированный или виртуальный объект способом, который не совпадает с ожиданием. Поэтому правила соединяют тип, соглашение об имени, заполненный alias и перечень разрешённых ролей. Изменение LLD сначала проверяется на одном устройстве; lost resources не удаляются поспешно, пока не выяснено, произошла ли перенумерация, переименование или реальное удаление порта.
Дребезг, опросы и уведомления устройства
Короткое чередование up и down я рассматриваю как link flapping, но не маскирую его простым длинным ожиданием. Debounce требует, чтобы состояние сохранялось выбранное время или несколько достоверных выборок; hysteresis задаёт разные условия открытия и закрытия, чтобы событие не переключалось на границе. Универсальной длительности нет. Для магистрали, пользовательского доступа, резервного канала и тестового порта различаются цена задержанного обнаружения и допустимость краткого разрыва. Я выбираю окно по бизнес-роли, частоте poll, поведению устройства и риску скрыть настоящую нестабильность. Отдельно действует правило административного контекста: admin down не является fault, если соответствует утверждённому намерению оператора. Trap и poll дают разные доказательства. Trap быстро сообщает, что агент заметил переход, но пакет может потеряться, задержаться, повториться или прийти без последующего устойчивого изменения. Poll устанавливает наблюдаемое состояние и freshness на момент запроса, однако между двумя опросами краткий переход способен исчезнуть. Я коррелирую timestamps уведомления, ifAdminStatus, ifOperStatus и свежего значения. Ни trap в одиночку, ни один poll не считаю полным доказательством причины. При расхождении сохраняю событие как диагностический сигнал, проверяю доставку, временную шкалу и следующий опрос, не создавая уверенный вывод из отсутствия одного пакета.
Безопасная диагностика и контролируемая проверка
Рабочий разбор начинается в Zabbix с Latest data, времени получения, состояния item, очереди и результата LLD. Я проверяю выбранный именованный SNMPv3 interface и привязку encrypted macros, не раскрывая их значения. Для верификации официальных OID подходит snmptranslate -On; он не обращается к устройству и не требует секрета. Точечный snmpget разрешаю только через заранее защищённую сессию net-snmp. Команда snmpget -v3 -l authPriv -u monitor_ro $SNMP_TARGET IF-MIB::ifAdminStatus.12 безопасна лишь при явном условии: authentication и privacy material читаются из защищённой конфигурации сессии и никогда не передаются аргументами. Тем же способом можно прочитать ifOperStatus, ifCounterDiscontinuityTime, snmpEngineBoots и snmpEngineTime. Вывод с идентификаторами не включается в заявку или статью. Причинный тест проводится исключительно в утверждённое maintenance window на явно обозначенном некритичном либо тестовом порту. При извлечении кабеля ожидаю admin up, oper down, возможный trap и подтверждение последующим poll. При согласованном shutdown ожидаю admin down и oper down без аварии. После включения или возврата кабеля должны появиться oper up, актуальный poll и, если настроено, уведомление восстановления. Опыт прекращается при неожиданном влиянии на соседний сервис, расхождении назначенного порта или утрате управления. Недопустимо изменять алгоритмы защиты, перезапускать устройство для подтверждения результата проверки или затрагивать рабочую линию.
Ввод в эксплуатацию, откат и пределы вывода
Перед распространением я сверяю прототипы items, выражения событий, LLD filter и overrides на небольшой однородной группе. Частоту опроса выбираю по скорости порта, бизнес-роли, профилю трафика, допустимой задержке обнаружения и нагрузке на агент. Такой же подход применяю к порогам rate, errors и discards: фиксированная величина без базового профиля либо назначения интерфейса порождает шум. Ввод считается завершённым, когда свежий poll читается минимальной учётной записью, административное отключение не создаёт fault, устойчивый oper down распознаётся, discontinuity не склеивает ряд, а исключённые LLD-объекты не возвращаются после очередного discovery. План возврата готовится заранее. Сначала отключаются новые зависимости мониторинга, чтобы Zabbix прекратил обращения и не создавал каскад unsupported items. Затем можно удалить только добавленные read-only user и VACM view либо восстановить сохранённую конфигурацию по проверенной процедуре. Никакие несвязанные параметры устройства при этом не меняются. После отката подтверждаю доступность управления и отсутствие запросов от отключённого мониторинга. Этот контроль не доказывает качество кабеля во всех режимах, отсутствие микропотерь, исправность соседнего узла или доступность приложения. IF-MIB описывает наблюдение агента, а результат зависит от реализации производителя и момента выборки. Поэтому я оставляю границы вывода явными и расширяю диагностику только при отдельной гипотезе, сохраняя принцип минимально необходимого чтения.
Сигналы, которые сопоставляю
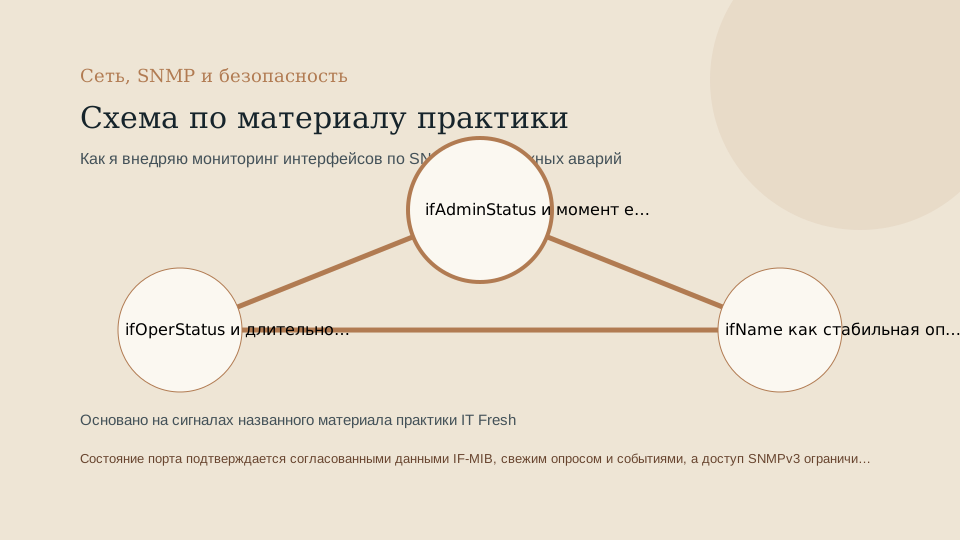
- ifAdminStatus и момент его последнего опроса
- ifOperStatus и длительность устойчивого состояния
- ifName как стабильная операционная подпись
- ifAlias как назначение порта
- ifType для политики обнаружения
- ifHighSpeed для выбора масштаба и проверки правдоподобия скорости
- ifHCInOctets .1.3.6.1.2.1.31.1.1.1.6
- ifHCOutOctets .1.3.6.1.2.1.31.1.1.1.10
- ifInErrors .1.3.6.1.2.1.2.2.1.14
- ifOutErrors .1.3.6.1.2.1.2.2.1.20
- ifInDiscards .1.3.6.1.2.1.2.2.1.13
- ifOutDiscards .1.3.6.1.2.1.2.2.1.19
- ifCounterDiscontinuityTime для границы непрерывного ряда
- snmpEngineBoots и snmpEngineTime для проверки временного окна USM
- время trap и соответствующего poll
- возраст последнего успешного значения Zabbix
- изменение индекса при неизменных ifName и ifAlias
- ожидаемое состояние по роли порта и окну обслуживания
Отвергнутые альтернативы
- Административное отключение по согласованной работе вместо физической аварии
- Краткий link flapping вместо устойчивого разрыва
- Потеря или задержка SNMP poll между Zabbix и устройством
- Trap доставлен с опозданием либо не доставлен
- Перезагрузка агента и разрыв счётчиков без повреждения линии
- Смена ifIndex или состава виртуальных интерфейсов
- Ошибочная LLD-политика, включившая служебный либо временный порт
- Рост ошибок или discards при сохранённом oper up
- Несовпадение контекста USM из-за обнаружения нового engine ID
Конфигурация и сбор
На устройстве я создаю отдельного USM user только для мониторинга с уровнем authPriv и явно согласованными authProtocol и privacyProtocol. Через VACM ему назначается read-only view, ограниченный требуемыми объектами IF-MIB и SNMP-FRAMEWORK-MIB; запись и доступ к посторонним ветвям исключаются. Если платформа позволяет, запросы дополнительно ограничиваются адресом источника мониторинга. В Zabbix применяется именованный интерфейс SNMPv3 и зашифрованные макросы для чувствительных параметров, без generic agent key. Фактические credentials, authentication keys, privacy keys, полный конфигурационный фрагмент и engine ID устройства нигде не публикуются.
Контролируемая проверка и свидетельство
Тест выполняется только в утверждённое окно обслуживания на явно назначенном некритичном или тестовом порту. Сначала фиксируются свежие poll-значения. При физическом отключении кабеля ожидается неизменный admin up, переход oper down и, при настройке устройства, link trap; следующий poll должен подтвердить состояние. При согласованном shutdown ожидаются admin down и oper down, но авария линии не создаётся. После восстановления проверяются trap, новый poll, возврат oper up, свежесть счётчиков и отсутствие ложного повторного события.
Фрагмент рабочего регламента
- В Zabbix проверить Latest data, время последнего значения, очередь опроса, именованный SNMPv3 interface, LLD filter и override; значения защищённых макросов не открывать и не экспортировать.
- Сверить административную политику порта с ifAdminStatus, затем физическое состояние с ifOperStatus, ifName и ifAlias.
- Для официального числового представления разрешено выполнить snmptranslate -On IF-MIB::ifHCInOctets, snmptranslate -On IF-MIB::ifHCOutOctets и snmptranslate -On IF-MIB::ifCounterDiscontinuityTime.
- Безопасный запрос: snmpget -v3 -l authPriv -u monitor_ro $SNMP_TARGET IF-MIB::ifAdminStatus.12. Материал аутентификации и приватности должен читаться из защищённой конфигурации сессии net-snmp и не передаваться аргументами.
- Через такую же защищённую сессию прочитать IF-MIB::ifOperStatus.12, IF-MIB::ifCounterDiscontinuityTime.12, SNMP-FRAMEWORK-MIB::snmpEngineID.0, SNMP-FRAMEWORK-MIB::snmpEngineBoots.0 и SNMP-FRAMEWORK-MIB::snmpEngineTime.0; результат не публиковать.
- Сопоставить timestamps trap и poll, не считая ни один канал отдельным исчерпывающим доказательством.
Откат
До изменения SNMPv3 сохраняется резервная копия конфигурации устройства и проверяется план восстановления. Откат не затрагивает посторонние настройки: сначала отключается зависимость мониторинга и связанные элементы Zabbix, затем удаляются только созданные read-only user и view либо восстанавливается сохранённая конфигурация по утверждённому плану. После возврата проверяются управление устройством и отсутствие продолжающихся запросов от мониторинга.
Ограничения вывода
Нет универсальной длительности debounce, интервала poll, мощности, порога трафика, ошибок или discards. Их выбирают по скорости порта, бизнес-роли, профилю нагрузки, допустимому времени обнаружения и риску пропуска события. Trap сообщает о событии, poll — о наблюдаемом состоянии и свежести; каждый канал имеет собственные потери и задержки. Поддержка алгоритмов, VACM и ограничений источника зависит от платформы устройства.
Источники
- https://www.rfc-editor.org/rfc/rfc3414.html
- https://www.rfc-editor.org/rfc/rfc2863.html
- https://www.zabbix.com/documentation/current/en/manual/config/items/itemtypes/snmp