
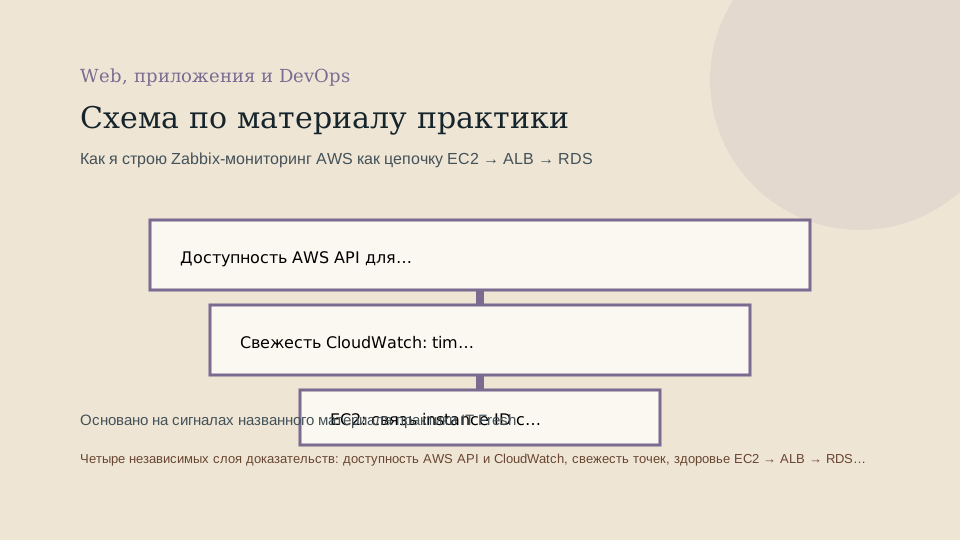

Начинаю с карты услуги, а не со списка AWS-метрик
В практике IT Fresh я сначала рисую путь запроса. Эту карту я, Семёнов Евгений Сергеевич, составляю как ведущий системный администратор IT Fresh. Я также основатель компании и технический директор IT Fresh, поэтому отвечаю за границы всей модели наблюдения. Пользователь обращается к опубликованному адресу, Application Load Balancer выбирает пригодную цель, приложение на EC2 обрабатывает запрос и при необходимости обращается к RDS. Рядом существует отдельный путь наблюдения: Zabbix аутентифицируется в AWS API, получает инвентарь и точки CloudWatch, а затем выполняет независимую HTTP-проверку. Эти пути пересекаются, но не равны друг другу. Если CloudWatch API недоступен для роли мониторинга, я теряю доказательства, но не объявляю отказ приложения. Если API отвечает, а последняя точка старая, состояние компонента остаётся неизвестным. Если все облачные ресурсы выглядят здоровыми, но HTTP-проверка не получает ожидаемый ответ, пользовательская проблема сохраняет собственный приоритет. Такая карта заранее защищает дежурного от главной ошибки: превращать отсутствие телеметрии в уверенный диагноз. В событии я показываю слой, возраст доказательства, регион и связанную сущность, чтобы человек видел не просто красный график, а место разрыва цепочки.
Доступность источника CloudWatch и AWS API выделяю отдельно
Первый технический сигнал отвечает только на вопрос, способен ли Zabbix получить корректный ответ от нужного AWS API. Я различаю сетевой timeout, ошибку DNS или TLS, ошибку подписи запроса, отказ IAM, ограничение частоты и корректный ответ сервиса. Текст AWS-ошибки очищаю от чувствительных данных и не отправляю целиком в уведомление. Для GetMetricData сохраняю состояние запроса и сообщения результата, а для Describe-вызовов — факт успешного чтения ожидаемого ресурса. Пустой список при неверном регионе, фильтре или идентификаторе не становится зелёным здоровьем. Сначала я сверяю регион и dimensions, затем решаю, исчез ли объект или неверен запрос. Этот слой получает собственное событие наблюдаемости. Пока оно активно, зависимые выводы по старым облачным данным помечаются неизвестными, но независимый web scenario продолжает работать. Так потеря учётных данных не маскирует реальный HTTP-отказ, а пользовательская проблема не объясняется автоматически ошибкой collector.
Свежесть данных измеряю по последней точке, а не по времени опроса
Успешный запуск item говорит, когда Zabbix выполнил запрос, но не говорит, когда AWS сформировал измерение. Поэтому я беру последнюю timestamp из ответа GetMetricData и вычисляю возраст относительно согласованного времени наблюдения. Отдельно храню момент последнего успешного API-вызова. Эти два возраста расходятся, если сервис ещё не опубликовал точку, запрос выбрал неподходящее окно или period, ряд не соответствует dimensions либо Zabbix повторно видит старые данные. Я не подставляю ноль вместо пустого ряда: нулевая нагрузка и отсутствие доказательства имеют разные последствия. Допустимую свежесть задаю для каждой метрики после проверки её документированной периодичности и поведения конкретного контура. Для EC2 дополнительно учитываю, включён ли detailed monitoring; это влияет на доступную периодичность метрик, но не даёт права обещать точное время их появления. Событие stale data закрывается только новой точкой, а не очередным успешным HTTP-ответом CloudWatch.
EC2 рассматриваю как вычислительный слой, а не всю услугу
Для экземпляров EC2 я начинаю с инвентаря DescribeInstances и связываю instance ID с конкретной target group, не полагаясь на похожий Name tag. StatusCheckFailed использую как документированный общий признак провала status checks, а CPUUtilization — как контекст работы ресурса. При необходимости набор расширяется только официальными метриками и данными установленного агента, если он согласован отдельно. Нормальный status check не доказывает, что процесс приложения слушает нужный порт, возвращает правильное содержимое или способен обратиться к базе. Высокий CPU тоже не является готовой первопричиной: он может быть следствием нагрузки, цикла ошибки или фоновой работы. Я сопоставляю момент изменения EC2 с target health, ответом ALB и пользовательской проверкой. Если instance недоступен, но ALB сохраняет достаточное число здоровых целей и синтетика успешна, событие относится к снижению резерва, а не к полному отказу услуги. Если же пользовательская проверка падает одновременно, зона влияния повышается на основании независимого доказательства.
ALB разделяю на собственные ошибки, цели и задержку
Application Load Balancer даёт несколько разных классов сигналов. HealthyHostCount и UnHealthyHostCount описывают результаты настроенных health checks целей. HTTPCode_ELB_5XX_Count относится к кодам 5xx, сформированным самим load balancer, тогда как HTTPCode_Target_5XX_Count учитывает ответы 5xx от целей. Я не складываю эти ряды в одну безымянную ошибку, потому что маршруты расследования различаются. TargetResponseTime показывает время до начала ответа цели в определении AWS, но сам по себе не называет виновный компонент. Dimensions обязаны соответствовать load balancer и target group, иначе правильное имя метрики даст неправильный или пустой ряд. DescribeTargetHealth дополняет CloudWatch текущими описаниями состояния конкретных targets, однако тоже не заменяет запрос пользователя. Причинное событие ALB открываю, когда свежие API- и метрические доказательства согласуются по одной сущности и времени. Производные сообщения экземпляров группирую под ним только при однозначной связи target ID; догадка по адресу или имени для suppression недостаточна.
RDS подтверждает состояние базы только в своей границе
Для RDS я получаю конфигурационный инвентарь через DescribeDBInstances и облачные ряды CPUUtilization, DatabaseConnections, FreeStorageSpace и FreeableMemory. Каждый из них отвечает на узкий вопрос. Число соединений не доказывает, что транзакции успешны; свободное хранилище не описывает задержку запроса; CPU без временной связи не объясняет ошибку приложения. Я не задаю единый процент или объём для всех классов экземпляров и движков. Сначала формирую обычный профиль конкретной базы, её рабочий цикл и согласованный предел, затем ввожу предупреждение с запасом для реакции владельца. Если HTTP-ошибки целей выросли вместе с исчерпанием ресурса RDS, это сильная гипотеза, но окончательное подтверждение требует разрешённой диагностики приложения или базы. Zabbix не выполняет тестовый SQL и не меняет параметры RDS в рамках этого материала. Когда DescribeDBInstances и CloudWatch доступны, а пользовательский запрос успешен, одиночное ресурсное отклонение остаётся сигналом ёмкости, а не ложным заявлением о недоступности сервиса.
Пользовательскую доступность проверяю независимым HTTP-сценарием
Облачные метрики я завершаю отдельной проверкой со стороны, близкой к согласованному пути пользователя. Zabbix web scenario или HTTP agent обращается к разрешённому URL, проверяет TLS, ожидаемый HTTP status и безопасный стабильный маркер ответа. Проверка не должна создавать запись, заказ, письмо или иной бизнес-эффект. Если нужна аутентификация, владелец предоставляет специальный минимальный тестовый контур; рабочие cookie и персональные данные я не копирую. Успех одной страницы не распространяю на всё приложение, а время ответа одного запроса не объявляю общим показателем производительности. Зато этот слой отвечает на важный вопрос, который не решают Describe и CloudWatch: получил ли выбранный клиентский путь приемлемый ответ сейчас. При недоступности AWS API синтетика продолжает давать ограниченное доказательство. При старых метриках и успешной синтетике я сообщаю о потере свежести наблюдения, не создавая вымышленный пользовательский сбой. При свежих зелёных ресурсах и отрицательной синтетике расследование остаётся открытым на уровне приложения, маршрута или проверки.
Группирую причины по свежим связям и не скрываю независимые симптомы
Шум уменьшаю через tags и зависимости, а не через широкое отключение уведомлений. Для каждого события передаю service, region, layer, resource ID и cause class. Потеря доступа к CloudWatch становится верхней причиной только для неизвестности облачных данных, но не подавляет отрицательный web scenario. Подтверждённый unhealthy target может сгруппировать отклонения связанного EC2, если target identity доказана. Исчерпание ресурса RDS не подавляет 5xx приложения автоматически: сначала нужна временная связь, а пользовательское влияние остаётся видимым в карточке причины. Я использую задержку подтверждения и recovery только после измерения периодичности данных; длинный hysteresis не должен скрывать потерю свежести. В сообщении дежурный видит не десяток графиков, а четыре строки: источник доступен, данные свежие, компонентное здоровье определено, пользовательская проверка успешна. Если один слой неизвестен, итог не становится зелёным. После каждого контролируемого теста я проверяю, какие события были подавлены, и отменяю зависимость, если она могла спрятать самостоятельный отказ.
Права проверяю по фактическим вызовам и сохраняю read-only границу
Минимальный перечень IAM actions я составляю от запросов, а не от названия сервиса. Для этой цепочки нужны чтение CloudWatch через cloudwatch:GetMetricData, инвентарь EC2 через ec2:DescribeInstances, описание балансировщика и целей через elasticloadbalancing:DescribeLoadBalancers и elasticloadbalancing:DescribeTargetHealth, описание базы через rds:DescribeDBInstances. Но даже этот список я не называю автоматически достаточным для любого готового шаблона Zabbix: конкретная версия может выполнять дополнительные discovery- или account-вызовы. Перед вводом я наблюдаю отказанные действия в согласованном тесте, сверяю их с официальной документацией шаблона и добавляю только обоснованное чтение. Actions изменения, регистрация и удаление targets, запуск или остановка instances, изменение RDS и настройка ALB не входят в роль. Где AWS не поддерживает resource-level restriction для Describe, ограничение строится также через отдельный аккаунт, роль, организационные controls и область самого collector; я не обещаю невозможную гранулярность одной policy.
Приёмку завершаю доказательствами, откатом и точным контактом
На приёмке я показываю владельцу четыре независимых результата на одной временной шкале: AWS API и CloudWatch доступны для роли; последняя точка каждой обязательной метрики укладывается в согласованную свежесть; EC2, ALB targets и RDS имеют определённое компонентное состояние; пользовательский HTTP-сценарий получает ожидаемый ответ. Затем повторяю безопасную controlled verification на тестовой цели или replay сохранённого ответа, проверяю одно причинное событие, видимые последствия и recovery только по новым данным. В журнале остаются идентификаторы без закрытых имён, timestamps, классы ответов, ожидаемое и фактическое поведение, а также владелец следующего действия. Rollback заранее отделяет отключение новых items и triggers от возврата тестовой цели владельцем AWS. Я не обещаю, что мониторинг предотвратит любой отказ: он делает границы знания явными и сокращает путь к проверяемой причине. Описание услуг опубликовано на https://itfresh.ru/. Для переписки использую канал https://t.me/ITfresh_Boss. Голосовой контакт доступен по tel:+79037296241.
Сигналы, которые сопоставляю
- Доступность AWS API для collector: сетевой результат, подпись, IAM-отказ, throttling, код и время ответа GetMetricData и Describe-вызовов.
- Свежесть CloudWatch: timestamp последней принятой точки и её возраст отдельно от времени успешного опроса Zabbix.
- EC2: связь instance ID с target group, StatusCheckFailed и согласованные ресурсные метрики без вывода о здоровье всего приложения.
- ALB: DescribeTargetHealth, HealthyHostCount, UnHealthyHostCount, HTTPCode_ELB_5XX_Count, HTTPCode_Target_5XX_Count и TargetResponseTime с корректными dimensions.
- RDS: DescribeDBInstances, CPUUtilization, DatabaseConnections, FreeStorageSpace и FreeableMemory как отдельные признаки состояния и ёмкости.
- Пользовательский слой: TLS, HTTP status, время ответа и безопасный маркер содержимого из Zabbix web scenario или HTTP agent.
- Причинная модель: service, region, layer, resource ID, cause class, freshness и независимое пользовательское влияние в tags и тексте события.
Отвергнутые альтернативы
- Считать успешный GetMetricData доказательством здоровья сервисаУспешный API-вызов подтверждает доступ к источнику и корректность запроса. Он может вернуть старую, пустую либо ещё не опубликованную точку и не проверяет пользовательский путь.
- Открывать отдельный инцидент на каждую метрику EC2, ALB и RDSОдин отказ upstream способен породить множество вторичных отклонений. Группировка по сервисной цепочке и свежим причинным доказательствам уменьшает шум, сохраняя исходные сигналы в истории.
- Считать HealthyHostCount достаточной проверкой приложенияTarget health отражает настроенную health check ALB. Она не обязана совпадать с реальным пользовательским URL, содержимым ответа, аутентификацией и зависимостью приложения от RDS.
- Приписывать рост TargetResponseTime базе RDSЗадержка цели не локализует причину. Нужны синхронные данные приложения, EC2, target health, RDS и независимый запрос; иначе база становится удобной, но недоказанной версией.
- Расширить IAM до административной политики ради простотыМониторингу достаточно чтения согласованных API. Права изменения увеличивают последствия ошибки и не добавляют достоверности сигналам.
Конфигурация и сбор
Для отдельной роли или пользователя мониторинга я оставляю только чтение тех данных, которые действительно запрашивает согласованный контур: cloudwatch:GetMetricData для выбранных метрик и временных окон, ec2:DescribeInstances для инвентаря EC2, elasticloadbalancing:DescribeLoadBalancers и elasticloadbalancing:DescribeTargetHealth для ALB и его target health, rds:DescribeDBInstances для инвентаря RDS. Я не добавляю права изменения ресурсов, не выдаю wildcard на действия и не считаю этот перечень универсальным: фактические запросы поддерживаемого шаблона Zabbix и политика AWS должны быть сверены до включения. Секреты хранятся в защищённых макросах Zabbix либо используются через согласованный механизм временных учётных данных; они не попадают в значения items, журнал проверки и текст события.
- Зафиксировать регион, идентификаторы EC2, ARN Application Load Balancer, target group и идентификатор RDS без переноса закрытых имён в публичные подписи; проверить, что все сущности действительно принадлежат одной сервисной цепочке.
- Подключить официальный шаблон AWS by HTTP либо его поддерживаемые компоненты версии установленного Zabbix, сверив macros и требуемые API-вызовы с документацией шаблона; произвольные неподписанные запросы к AWS API не использовать.
- Получать метрики CloudWatch через GetMetricData с явными namespace, dimensions, period и окном времени; сохранять статус самого запроса, timestamp последней принятой точки и возраст этой точки как разные диагностические значения.
- Для EC2 собирать StatusCheckFailed и согласованные ресурсные метрики, для ALB — HealthyHostCount, UnHealthyHostCount, HTTPCode_ELB_5XX_Count, HTTPCode_Target_5XX_Count и TargetResponseTime, для RDS — CPUUtilization, DatabaseConnections, FreeStorageSpace и FreeableMemory только в тех сочетаниях dimensions, которые описаны AWS.
- Добавить независимый Zabbix web scenario или HTTP agent к разрешённому пользовательскому URL ALB: проверять TLS, ожидаемый HTTP status и безопасный признак ответа, не передавая рабочие персональные данные и не обходя штатную аутентификацию.
- Привязать события через tags сервиса, региона, слоя и класса причины; производные симптомы подавлять лишь при свежем подтверждении причины, а пользовательскую HTTP-недоступность оставлять самостоятельным доказательством влияния.
Контролируемая проверка и свидетельство
Контролируемую проверку я начинаю без изменения AWS: выполняю один разрешённый Describe-запрос для каждого слоя, один GetMetricData на коротком согласованном окне и один безопасный пользовательский HTTP-запрос. Сверяю код и время ответа API, последнюю timestamp CloudWatch, состояние ресурсов и результат web scenario. Проверку корреляции сначала провожу на сохранённых обезличенных ответах через preprocessing test или на отдельно выделенной тестовой цепочке. Если владелец разрешил воздействие, он выполняет одно заранее выбранное обратимое действие только над тестовой целью, например временно выводит тестовый target из обслуживания штатным способом, а я не выдаю команды изменения из Zabbix. До действия записываю ожидаемые доказательства: изменение DescribeTargetHealth, изменение HealthyHostCount или UnHealthyHostCount после появления новой точки CloudWatch, сохранение доступности AWS API и ожидаемое поведение пользовательского URL с учётом оставшихся targets. Проверка прекращается при неожиданном влиянии, ошибке прав, росте задержки рабочего запроса или потере наблюдаемости. Восстановлением считаю не ручное закрытие события, а новое read-only подтверждение target health, свежую точку CloudWatch, нормальное здоровье компонентов и успешную пользовательскую проверку. Если безопасной тестовой цели нет, воздействие не провожу.
Фрагмент рабочего регламента
- Проверить доступность AWS API из точки сбора и отдельно записать ошибку подписи, 401/403, throttling, timeout либо корректный ответ; не превращать ошибку доступа в отказ всех ресурсов.
- Выполнить разрешённые DescribeInstances, DescribeLoadBalancers, DescribeTargetHealth и DescribeDBInstances для ограниченного набора идентификаторов; сопоставить регион, ARN и связи цепочки.
- Вызвать GetMetricData для согласованного окна и проверить StatusCode, Messages, Timestamps и Values; возраст вычислять от последней принятой точки, а пустой ряд не заменять нулём.
- Сопоставить EC2 StatusCheckFailed, ALB target health и его CloudWatch-метрики, затем RDS CPUUtilization, DatabaseConnections, FreeStorageSpace и FreeableMemory на одной временной шкале.
- Запустить один Zabbix web scenario или HTTP agent к разрешённому URL, проверить TLS, HTTP status, время ответа и безопасный маркер содержимого; не отправлять изменение данных.
- Перед эскалацией назвать четыре результата отдельно: источник AWS API/CloudWatch доступен или нет, данные свежие или нет, компонент здоров или нет, пользовательская проверка успешна или нет.
Откат
Откат мониторинга отделяю от восстановления тестового объекта. В AWS владелец возвращает только заранее изменённую тестовую цель в исходное состояние штатной операцией и подтверждает её через DescribeTargetHealth; Zabbix не выполняет изменение. В конфигурации мониторинга я отключаю новые triggers и actions, отвязываю только добавленный шаблон или тестовый host, возвращаю сохранённые интервалы и filters LLD, затем удаляю временные macros и временную IAM policy после подтверждения владельца. Если новая роль использовалась только для пилота, её отзыв выполняется владельцем AWS после экспорта перечня фактически нужных read-only действий. Я сохраняю обезличенные timestamps и классы ответов для разбора, но удаляю временные payload, идентификаторы и отладочные значения по принятому сроку. После отката проверяю, что старый контур продолжает собирать данные, очередь Zabbix не выросла, web scenario не создаёт трафик, а в AWS не осталось изменения тестовой цели. Рабочие EC2, ALB, target groups, RDS, security groups и маршруты мониторинг не удаляет и не перенастраивает.
Ограничения вывода
CloudWatch отражает опубликованные сервисами метрики, а не все внутренние причины. Доступный AWS API не доказывает, что новая точка метрики уже опубликована; свежая метрика не доказывает здоровье соседнего слоя; здоровые EC2, ALB и RDS по отдельности не гарантируют успешный пользовательский сценарий. Частота и доступность метрик зависят от сервиса, выбранной настройки и периода, поэтому я не задаю универсальный допустимый возраст данных и не обещаю одинаковую задержку. Basic и detailed monitoring EC2 дают различную периодичность поддерживаемых метрик. Метрики ALB имеют собственные правила публикации и dimensions, а нулевое или отсутствующее значение нельзя трактовать без их документации. Метрики RDS не заменяют Performance Insights, Enhanced Monitoring или прикладную проверку соединения. DescribeDBInstances показывает конфигурационное состояние, но не подтверждает выполнение запроса приложением. Синтетический HTTP-запрос может подтвердить только выбранный URL, метод, регион и момент времени; он не доказывает качество всех функций. IAM policy следует проверить по реальным вызовам конкретной версии шаблона и ограничениям организации. Этот контур не исправляет AWS автоматически, не гарантирует SLA и не устанавливает универсальную первопричину без временной связи доказательств.
Источники
- Amazon CloudWatch API: GetMetricData
- Amazon EC2 metrics and dimensions
- CloudWatch metrics for your Application Load Balancer
- Amazon CloudWatch metrics for Amazon RDS
- Actions, resources, and condition keys for Amazon EC2
- Actions, resources, and condition keys for Elastic Load Balancing V2
- Actions, resources, and condition keys for Amazon RDS
- Zabbix integrations: AWS
- Zabbix documentation: HTTP agent
- Zabbix documentation: Web monitoring
- Zabbix documentation: Low-level discovery