

Разделяю три уровня здоровья
В наших внедрениях я начинаю с разделения вопросов, которые часто ошибочно сводят к одному зелёному индикатору. Первый вопрос — существует ли нужный application pool, запущен ли он и соответствует ли ожидаемой конфигурации. Второй — как ведёт себя связанный worker process: не растут ли его память, процессорное время, потоки или дескрипторы, не повторяются ли завершения и запуски. Третий — способен ли пользовательский маршрут вернуть правильный ответ, включая обращения приложения к обязательным HTTP-зависимостям. Работающий w3wp.exe не доказывает, что endpoint отвечает содержательно; успешный HTTP-ответ через балансировщик не доказывает, что конкретный пул на конкретном узле здоров. Поэтому я оставляю отдельные items и триггеры для состояния пула, ресурсов процесса и HTTP-проверок. Их связывают теги узла, приложения, пула, компонента и зависимости. Такое разделение помогает дежурному увидеть, где кончается факт наблюдения и начинается гипотеза о причине, а владельцам сервиса — не принимать отказ внешнего API за поломку IIS.
Фиксирую состояние, identity и recycling
Сначала я составляю разрешённый перечень пулов и сопоставляю каждый с приложением и ожидаемой моделью запуска. Состояние читается поддерживаемым средством Windows или IIS с минимальными правами; запись конфигурации мониторингу не нужна. Рядом я фиксирую тип identity, но не имя с секретом, пароль или содержимое защищённых настроек. Это позволяет заметить неожиданную смену контекста исполнения, не превращая Zabbix в хранилище учётных данных. Отдельно я проверяю параметры и события recycling: плановый перезапуск, изменение конфигурации и аварийное завершение имеют разный диагностический смысл. Короткое появление двух PID во время перекрывающейся ротации не считаю автоматически неисправностью. Напротив, повторяющиеся незапланированные старты, отсутствие ожидаемого процесса после запроса или несоответствие PID пулу требуют изучения событий WAS и Application. Я не предлагаю Zabbix самостоятельно запускать или перерабатывать пул. Действие остаётся в утверждённой операционной процедуре владельца IIS, потому что мониторинг должен сохранять исходные свидетельства, а не стирать их первой реакцией.
Привязываю счётчики к worker process
Для раннего обнаружения деградации я собираю поддерживаемые Windows performance counters через Zabbix agent либо другой согласованный механизм чтения. Обычно полезны CPU, private bytes, working set, потоки, дескрипторы, запросы и очереди, но окончательный набор зависит от версии Windows, IIS и приложения. Главная трудность — экземпляры w3wp могут менять имена и PID после recycling. Я проверяю связь процесса с пулом и не строю вывод по случайному экземпляру счётчика. Базовую линию формирую по истории самого приложения: устойчивый рост памяти между ротациями отличается от краткого прогрева, а высокая загрузка под известным потоком запросов отличается от зависания без полезной работы. Порог я выбираю после наблюдения за рабочим профилем и ёмкостью хоста, а не переношу одинаковое число между системами. Для шума важны длительность состояния, повторное подтверждение и сочетание сигналов. Например, рост ресурса становится убедительнее вместе с увеличением времени ответа или очереди, однако один всплеск после старта остаётся диагностическим событием, а не поводом к вмешательству.
Проверяю HTTP-ответ по смыслу
HTTP agent в Zabbix я использую как независимый взгляд на доступность приложения. Для каждой точки заранее определяю допустимый метод, ожидаемую категорию status code, правила перенаправления и небольшой устойчивый признак ответа. Код успеха без проверки тела недостаточен: прокси может вернуть собственную страницу, endpoint — форму авторизации вместо результата, а обработчик — формально успешный пустой документ. Одновременно слишком длинное или изменчивое совпадение делает проверку хрупкой. Поэтому я выбираю нейтральный признак версии схемы, состояния компонента или обязательного поля, не содержащий пользовательских данных. Если endpoint требует авторизации, секрет не помещается в статью, имя item или открытый параметр; способ хранения и доступа согласуется отдельно. Там, где безопасной учётной схемы нет, я оставляю ограниченную анонимную проверку и прямо записываю её предел. Время ответа оцениваю относительно профиля конкретного маршрута. Измерение снаружи узла и локальная проверка могут отвечать на разные вопросы, поэтому место выполнения проверки также фиксируется в описании элемента.
Отделяю endpoint от его зависимостей
Приложение IIS нередко отвечает собственным health endpoint, хотя обязательная внешняя HTTP-зависимость уже недоступна, либо, наоборот, объявляет об общей деградации при исправном пуле. Я не смешиваю эти факты. Для контролируемых зависимостей создаю отдельные HTTP items с понятным владельцем и проверяю статус вместе с содержательным полем ответа. Если чужой сервис нельзя опрашивать напрямую или это создаёт нагрузку, использую предоставленный приложением агрегированный признак и отмечаю его ограничение. Теги component, application, pool, dependency и проверяемая сторона позволяют строить зависимости триггеров: первичное событие внешнего компонента подавляет повторные уведомления от потребителей, но не удаляет их данные. Я избегаю цепочек, скрывающих локальную неисправность IIS за общим событием сети. Связь вводится только там, где причинность понятна и подтверждается маршрутом запроса. В сообщении остаются наблюдаемый endpoint, тип нарушения и ссылка на runbook без реальных адресов и параметров доступа. Так дежурный видит, какой слой сообщил о проблеме, и не начинает с необоснованного recycle.
Веду расследование от факта к причине
Когда приходит событие, я сначала проверяю его свежесть и область: один узел, один пул, весь сайт или внешняя зависимость. Затем сопоставляю HTTP status, проверку содержимого и задержку с состоянием пула. Если пул остановлен, изучаю события WAS и изменения конфигурации; если запущен, связываю текущий PID с процессными счётчиками и временем последнего recycling. При живом и стабильном процессе перехожу к журналам IIS, очередям запросов и маршруту до зависимости. Если внешний endpoint нарушен одновременно для нескольких потребителей, проверяю зависимость и сетевую сторону, не меняя каждый пул. Я отмечаю временную последовательность: что произошло раньше, сохраняется ли рост ресурса, совпадает ли ошибка с ротацией или прогревом. Данные читаю в пределах разрешённого окна и маскирую URL-параметры, заголовки и пользовательские сведения. Только после этого формулирую проверяемую гипотезу. Такая последовательность не гарантирует диагноз по одним метрикам, зато сохраняет различие между симптомом HTTP, состоянием IIS и деградацией процесса и помогает передать владельцу приложения компактный набор свидетельств.
Снижаю шум и безопасно подтверждаю гипотезу
Защиту от лишних уведомлений я строю на свойствах конкретного сервиса. Учитываю холодный старт, перекрывающийся recycling, обслуживание, краткие сетевые ошибки и различие между редким endpoint и постоянно нагруженным маршрутом. Триггер получает временное подтверждение, гистерезис или сочетание условий только после анализа истории; универсальные значения я не назначаю. Зависимости событий подавляют каскад, а теги направляют проблему команде, способной её проверить. Для доказательства гипотезы я выбираю стенд, изолированный пул или согласованное окно и меняю один фактор. Можно безопасно вызвать непроизводительный контрольный endpoint, проверить ожидаемую реакцию на недоступную тестовую зависимость или наблюдать запланированный recycling. Нагрузочные воздействия без согласования не выполняю. Критерии остановки определяю заранее: неожиданный рост ошибок, влияние на соседние приложения или потеря наблюдаемости прекращают проверку. Восстановление подтверждаю не закрытием одного trigger, а возвращением пула в ожидаемое состояние, появлением корректного PID, стабилизацией счётчиков и несколькими содержательно верными HTTP-ответами с обеих нужных точек наблюдения.
Оставляю runbook, откат и честные границы
В read-only runbook я оставляю короткий порядок: определить затронутые теги, открыть последние значения HTTP и процесса, сверить состояние пула и PID, прочитать разрешённые события WAS, Application и журналы IIS, затем проверить зависимость со стороны утверждённой точки сбора. Для этой работы достаточно роли чтения в Zabbix и минимально необходимого доступа к данным мониторинга Windows и IIS; административные права, секреты сервисных учётных записей и право изменения пула не выдаются. Перед любой согласованной корректировкой владелец сохраняет прежнюю версию конфигурации и способ возврата. Откат означает восстановление единственного изменённого условия, а затем повторную проверку состояния пула, нового процесса, журналов и содержательного HTTP-ответа. Я явно записываю ограничения: performance counters не заменяют дамп и профилировщик, HTTP-проверка не видит все пользовательские пути, агрегированный health endpoint зависит от качества собственной реализации, а отсутствие тревоги не доказывает исправность каждой зависимости. Если привязка PID к пулу ненадёжна или доступ на чтение не согласован, соответствующий вывод не строится; пробел остаётся видимым риском. В рабочей записи я также отмечаю владельца каждого сигнала и путь эскалации без персональных контактов. Это важно при частичном восстановлении: пул уже запущен, но зависимость ещё отвечает неверно, либо внешний маршрут исправен, а один узел продолжает накапливать запросы. Закрывать расследование можно только после сопоставления всех первоначально нарушенных признаков. Историю изменения настроек мониторинга я сохраняю отдельно от эксплуатационных журналов, чтобы последующая проверка отличала смену правила оповещения от реального изменения поведения приложения.
Сигналы, которые сопоставляю
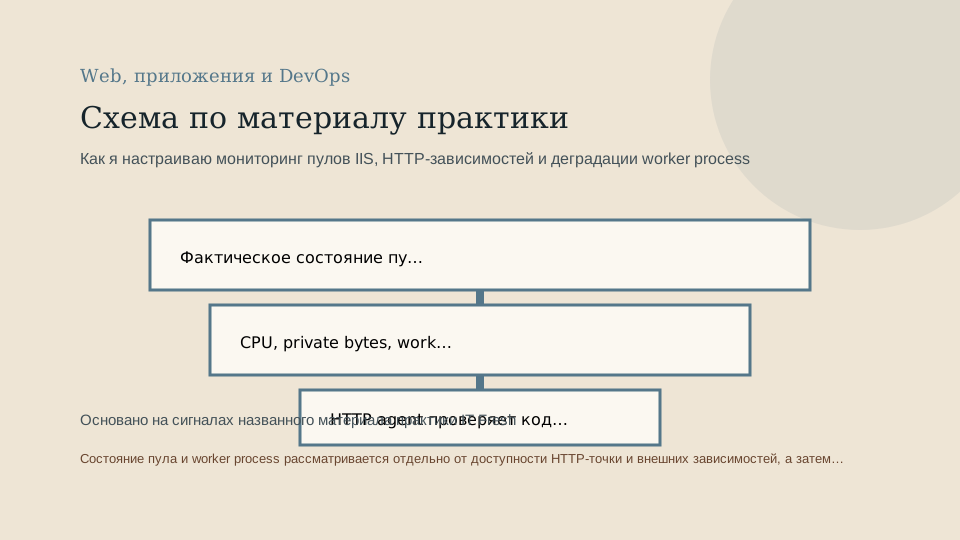
- Фактическое состояние пула, ожидаемая модель запуска, identity и события recycling рассматриваются вместе, но без чтения секретов учётной записи.
- CPU, private bytes, working set, число потоков, handle count и динамика worker process сопоставляются с PID и пулом, а не оцениваются как безымянный процесс w3wp.
- HTTP agent проверяет код ответа, время и содержательный признак в теле; успешное соединение само по себе не считается здоровьем приложения.
- Отдельные элементы и теги описывают локальный endpoint, цепочку зависимостей и подтверждённое восстановление после контролируемой проверки.
Отвергнутые альтернативы
- Считать наличие w3wp.exe доказательством исправности сайтаПроцесс может существовать при остановленном отдельном пуле, зависшем приложении или неработающей HTTP-зависимости; нужна привязка процесса к пулу и проверка пользовательского ответа.
- Оценивать HTTP-точку только по доступности TCP-портаСоединение может устанавливаться, пока приложение возвращает ошибку, страницу входа, заглушку балансировщика или неполный ответ.
- Автоматически выполнять recycle при росте любого счётчикаRecycle меняет наблюдаемое состояние, может скрыть утечку и прервать запросы; без расследования и разрешённой процедуры такая реакция небезопасна.
- Один триггер применять ко всем пулам и приложениямПрофиль нагрузки, модель запуска, допустимое время прогрева и характер зависимостей различаются, поэтому условия требуют локального обоснования.
Конфигурация и сбор
Роль только для чтения нужных hosts, latest data, problems и graphs в Zabbix; на Windows — минимальный доступ к разрешённым performance counters, состоянию IIS и выбранным журналам. Изменение application pools, чтение паролей, токенов и закрытых настроек не требуется.
- Сопоставить разрешённый перечень приложений, пулов и HTTP-точек без копирования реальных адресов в общедоступные материалы.
- Проверить поддерживаемый способ чтения состояния пула, PID и счётчиков на целевой версии Windows и Zabbix agent.
- Создать раздельные элементы для состояния пула, процесса, локального endpoint и зависимости, добавив согласованные теги.
- Настроить содержательную проверку ответа и хранить любые необходимые секреты только в утверждённом защищённом контуре.
Контролируемая проверка и свидетельство
На стенде, в изолированном пуле либо в согласованном окне выполняется одна безопасная проверка: наблюдение запланированного recycling, обращение к непроизводительной HTTP-точке или временная недоступность специально подготовленной тестовой зависимости. До начала фиксируются исходные значения и критерии остановки. Восстановление подтверждается состоянием пула, корректной привязкой PID, стабилизацией процесса и содержательно верным HTTP-ответом; автоматическое управляющее действие из Zabbix не используется.
Фрагмент рабочего регламента
- Уточнить область события по тегам application, pool, node, component и dependency.
- Сопоставить HTTP status и признак тела со состоянием пула, PID и последним recycling.
- Прочитать доступные события WAS и Application, журналы IIS и динамику счётчиков, не извлекая секреты и персональные данные.
- Проверить зависимость с разрешённой точки и зафиксировать временную последовательность наблюдений.
- После разрешённого действия подтвердить восстановление каждого затронутого слоя, а не только закрытие события.
Откат
Перед согласованным изменением сохраняются прежняя версия конфигурации мониторинга, привязка items и единственный изменяемый параметр IIS или приложения. При ухудшении владелец возвращает это изменение утверждённым способом. Затем я проверяю состояние пула, соответствие PID, события запуска, динамику ресурсов и содержательный HTTP-ответ. Мониторинг не выполняет restart или recycle автоматически.
Ограничения вывода
Нельзя назначить одинаковые интервалы опроса, пороги памяти, CPU, времени ответа или число подтверждений для всех IIS-систем. Выбор зависит от версии, модели запуска, профиля нагрузки, стоимости проверки, архитектуры балансировки и требований владельца. Счётчики показывают признаки, но не доказывают утечку или дефект кода; HTTP agent видит только выбранный маршрут; read-only наблюдение не заменяет разрешённые средства углублённой диагностики.