

Почему зелёной службы мне недостаточно
В наших внедрениях разбор начинается с наблюдаемого симптома: пользователь долго открывает форму, веб-клиент отвечает ошибкой или регламентная операция не дала ожидаемого результата. Я не переношу этот симптом прямо на процесс Windows или Linux. Сначала раскладываю путь на агент сервера ragent, менеджер кластера rmngr, рабочий процесс rphost, информационную базу, СУБД и канал публикации. ragent обеспечивает вход в серверную часть и координацию кластера, rmngr управляет его внутренними сервисами, а rphost исполняет прикладную работу сеансов. Поэтому три запущенных типа процессов — полезный базовый факт, но не доказательство работоспособности конкретной операции. Дополнительно отмечаю версию процесса, адрес узла, порт и принадлежность к кластеру: параллельно установленные версии платформы иначе легко дают убедительный, но чужой зелёный сигнал. В Zabbix я храню признаки каждого слоя раздельно и строю событие из их сочетания. Если исчез ragent, ветвь короткая; если процессы живы, но HTTP-шаг не проходит, расследование продолжается на уровне публикации, базы и зависимостей.
Что я читаю через rac и ras
Для инвентаризации я применяю штатный rac через доступный ras либо безопасный API с эквивалентной моделью прав. Сбор выполняется только на чтение: список кластеров, рабочих серверов, менеджеров, рабочих процессов, информационных баз, соединений и сеансов. Идентификаторы нужны для связи сущностей, но в публичные подписи я вывожу устойчивые технические псевдонимы, а не имена пользователей и баз. Команда запускается сервисной учётной записью с минимально достаточными административными правами кластера; интерактивный вход и изменение параметров ей не выдаются. Секрет передаётся через защищённое хранилище агента, не аргументом командной строки и не пользовательским макросом открытого типа. Мы проверяем код возврата, время ответа и полноту обязательных полей. Вывод парсится с учётом версии утилиты; локализованный текст ошибки и переносы строк не должны становиться полями обнаружения. Ограничение времени защищает очередь проверок от зависшего ras. Пустой список при ошибке разбора не превращается в ноль объектов: это отдельная ошибка сборщика, иначе исчезновение всех rphost можно ошибочно принять за спокойный кластер.
Распределение нагрузки между rphost
После обнаружения объектов я сопоставляю каждый rphost с рабочим сервером, PID, числом соединений и сеансов, доступной метрикой памяти процесса и моментом последнего корректного опроса. Важна не магическая граница, а форма распределения. Один процесс может удерживать заметно больше памяти и сеансов, тогда как соседние почти свободны; общий график хоста этот перекос сгладит. Я сравниваю процессы одной роли и одной версии платформы в сопоставимом рабочем окне, учитываю плановые перераспределения и завершение старых процессов. Рядом отмечаю доступность ноды, ёмкость её памяти и назначенные требования функциональности: равное число сеансов на неодинаковых серверах не обязательно означает правильный баланс. Отдельно сверяю память ОС: сумма рабочих наборов, private bytes или RSS имеет иной смысл, чем свободная память узла, и смешивать эти величины нельзя. Если PID сменился, ряд старого экземпляра закрывается, а новый начинается заново. Решение принимаю после проверки привязки сеансов и событий к конкретному процессу, а не после автоматического требования перезапустить самый крупный rphost.
Технологический журнал как узкий диагностический канал
Когда метрики показывают деградацию, но не объясняют её, я на ограниченное время подключаю технологический журнал. Область задаю точечно: нужный серверный процесс, конкретное временное окно и небольшой набор событий, например ошибки, начало и завершение серверного вызова, ожидания СУБД или взаимоблокировки, если такая детализация действительно нужна гипотезе. Поля с текстами запросов, представлениями данных, параметрами, именами пользователей и прикладным контекстом по умолчанию не собираю. Разрешённые строки проходят редактирование: адреса, логины, имена ИБ, значения параметров и потенциальные персональные данные заменяются до передачи в Zabbix. Для счётчиков беру агрегат по типу события и процессу, а исходный фрагмент оставляю на защищённом узле с более строгим доступом. Контролирую размер каталога, скорость прироста и ротацию. После диагностического окна фильтр снимается. Постоянно держать подробный журнал ради будущего инцидента я не применяю: стоимость и риск такого наблюдения несоразмерны, а полезный сигнал теряется в объёме.
HTTP-транзакция не заменяет здоровье платформы
Опубликованную информационную базу я проверяю отдельной синтетической HTTP-транзакцией. Она идёт по тому же DNS-имени, TLS и маршруту, которые разрешены для контрольного клиента, получает ожидаемый код ответа, проверяет ограниченный признак страницы и измеряет этапы соединения и ответа. Я запрещаю автоматическое принятие неожиданного перенаправления: страница прокси, форма аварийной аутентификации или заглушка балансировщика также способны вернуть успешный код. Тестовая база или специальная безопасная точка предпочтительнее входа в рабочий интерфейс; если аутентификация обязательна, используется отдельная учётная запись без доступа к документам и отчётам. Тело ответа не сохраняется, cookie и токены редактируются, переходы, создающие данные, запрещены. Этот сигнал отвечает только на вопрос о публикации и выбранном маршруте. Успешный HTTP не подтверждает выполнение серверной операции в rphost, а живой rphost не подтверждает работу веб-сервера. В Zabbix это разные items и разные причины событий, которые сходятся лишь в корреляции симптома.
Как я отделяю СУБД, блокировку и длинную транзакцию
Если сеанс завис на серверном вызове, следующим слоем становится СУБД. Мы проверяем доступность соединения от сервера 1С, задержку простого разрешённого запроса, исчерпание пулов, состояние журналов транзакций, дисковые задержки и штатные представления активных запросов. Учётная запись мониторинга получает только права просмотра необходимых системных представлений. Ожидание блокировки подтверждается цепочкой ожидающий—владелец ресурса и временем ожидания, а не общей длительностью запроса. Длинная транзакция может активно читать, писать или ждать ввод-вывод без блокирующего владельца; её альтернативами остаются неудачный план, нехватка памяти, обслуживание индекса и медленное хранилище. Повторный опрос важнее единичного снимка: владелец мог завершиться между выборками, поэтому отсутствие строки после события не опровергает ранее зафиксированное ожидание. Я связываю серверный вызов 1С и наблюдение СУБД по временному окну и обезличенному идентификатору. Текст запроса, параметры и содержимое таблиц в мониторинг не отправляются. Такое разделение не даёт автоматически обвинить кластер в задержке, возникшей ниже него.
Фоновые задания наблюдаю только по разрешённому результату
ОС-процесс не сообщает, завершилось ли регламентное или фоновое задание с прикладным результатом. Поэтому я добавляю такой контроль лишь тогда, когда владелец системы предоставляет разрешённый источник: служебный регистр статусов, безопасный HTTP-метод, журнал выполнения без содержимого документов или подготовленную агрегированную метрику. Мы заранее фиксируем смысл полей: идентификатор типа задания, время старта и окончания, состояние, технический код ошибки и актуальность записи. Имена контрагентов, документы, суммы и текст исключения с пользовательскими данными не выгружаются. Источник должен обновлять отметку атомарно после фактического завершения, иначе старое успешное значение переживёт новый неудачный запуск и создаст именно ту ложную уверенность, которой мы избегаем. Если источник отсутствует, честно оставляю пробел в покрытии и не вывожу успех из наличия фонового rphost. Задание, которое не запускалось по календарю, отличается от выполняющегося дольше обычного и от завершившегося ошибкой. Эти состояния требуют разных выражений и обязательной проверки расписания, часового пояса и периода обслуживания.
Контролируемая проверка и путь назад
Перед включением контроля я сохраняю исходную конфигурацию элементов, фильтра технологического журнала и права сервисных учётных записей. Проверку начинаю на одном рабочем сервере или тестовой ИБ: выполняю read-only запрос rac, убеждаюсь в корректной связи UUID, PID и сущностей, затем сверяю несколько значений со штатной консолью администрирования. Для HTTP использую безопасный запрос без изменения данных. Искусственную ошибку допускаю только контролируемую: временно неверный адрес тестовой точки либо остановка специального стендового компонента, никогда не рабочего rphost. До опыта задаю признак остановки и ответственного, чтобы тест не превратился в незамеченную постоянную конфигурацию. Мы проверяем появление и закрытие события, отсутствие секретов в latest data и журнале агента, нагрузку сборщика и прекращение диагностической записи. Если выросло время ответа, объём журнала или нарушилось обнаружение, откат возвращает прежние items, права и фильтр; новые сущности отключаются, а не маскируются пустыми значениями. После отката повторно подтверждаю обычный сбор и документирую оставшуюся границу наблюдаемости.
Сигналы, которые сопоставляю
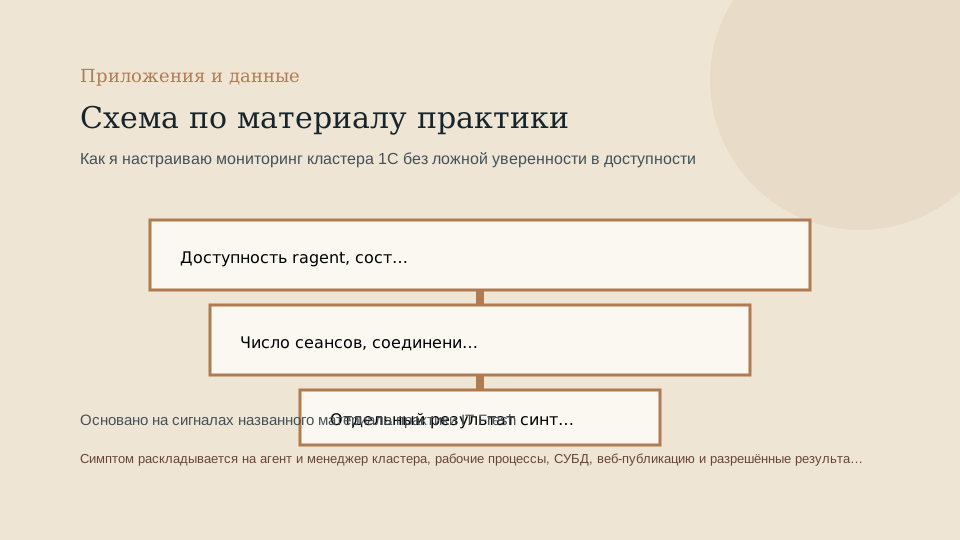
- Доступность ragent, состав менеджеров rmngr и рабочих процессов rphost с привязкой к рабочим серверам.
- Число сеансов, соединений и объём памяти по каждому rphost, а не только итог по узлу.
- Отдельный результат синтетического HTTP-шагa опубликованной информационной базы без смешения с состоянием служб платформы.
- Ошибки и длительности на стороне СУБД, альтернативные гипотезы блокировки и длинной транзакции, разрешённые результаты фоновых заданий.
Отвергнутые альтернативы
- Считать работающую службу агента доказательством доступности 1Сragent может принимать соединение, пока конкретный rmngr, rphost, информационная база, веб-сервер или СУБД уже не обслуживают нужный путь пользователя.
- Суммировать память всех rphost одним числомОбщий объём скрывает процесс с нетипичным числом сеансов, перекос распределения и постепенный рост отдельного рабочего процесса.
- Включить технологический журнал на все события и контекстыНеограниченный сбор создаёт лишнюю нагрузку, быстро заполняет диск и повышает риск попадания прикладных и персональных данных.
- Проверять бизнес-операцию привилегированной учётной записьюТакой тест расширяет последствия утечки и способен пройти по пути, недоступному обычному пользователю, создав ложноположительное подтверждение.
- Любую задержку объяснять блокировкой СУБДПохожий симптом дают длинная транзакция без ожидания блокировки, тяжёлый запрос, очередь фоновых работ, исчерпание соединений и задержка файловой подсистемы.
Конфигурация и сбор
Read-only доступ rac/ras или безопасного API к разрешённым объектам кластера; минимальные права просмотра системных представлений СУБД; отдельная HTTP-учётная запись без доступа к прикладным данным. Секреты, пользовательские значения и содержимое документов не собираются.
- Получить кластеры, рабочие серверы, менеджеры, рабочие процессы, информационные базы, соединения и сеансы, сохраняя ошибку запроса отдельно от пустого результата.
- Связать rphost с сервером и PID, собрать память и распределение сеансов по экземплярам, отметить смену процесса.
- При диагностике включить ограниченный фильтр технологического журнала, редактировать чувствительные поля и контролировать ротацию.
- Проверить HTTP-публикацию отдельной транзакцией и сопоставить её с метриками платформы, СУБД и разрешёнными статусами заданий.
Контролируемая проверка и свидетельство
На тестовой ИБ или одном изолированном объекте выполняется read-only обнаружение и сверка со штатной консолью. Отдельно запускается безопасный HTTP-запрос без записи данных. Проверка прекращается при росте нагрузки, появлении чувствительных значений, увеличении технологического журнала сверх согласованного объёма или влиянии на рабочие сеансы.
Фрагмент рабочего регламента
- Зафиксировать симптом и определить слой: процессы платформы, конкретная ИБ, публикация, СУБД или фоновое задание.
- Проверить ragent, rmngr и rphost, затем прочитать через rac/ras связи рабочих серверов, процессов и сеансов.
- Сопоставить перекос памяти и сеансов с узким окном редактированного технологического журнала и состоянием СУБД.
- Проверить независимую HTTP-транзакцию и использовать результат задания только из заранее разрешённого источника.
Откат
До теста сохраняются прежние элементы, правила обнаружения, права учётных записей и конфигурация технологического журнала. Откат отключает новые items и HTTP-сценарий, восстанавливает исходный фильтр или полностью прекращает диагностическую запись, отзывает добавленные права и подтверждает обычную работу штатными read-only проверками.
Ограничения вывода
Мониторинг не доказывает корректность всех прикладных операций и не читает содержимое документов. rac/ras отражает административное состояние на момент опроса, HTTP-транзакция — только выбранную публикацию, а системные представления СУБД — доступное окно наблюдения. Без разрешённого прикладного источника нельзя достоверно утверждать успех регламентного задания.