Границы материала
Linux/systemd; прямой NGINX → FastCGI; пример пакетной раскладки Debian/Ubuntu PHP 8.3. Для PHP 8.4 пути и unit проверяются отдельно. pm.status_listen — PHP >= 8.0. Совместимость конкретного шаблона Zabbix не заявляется.
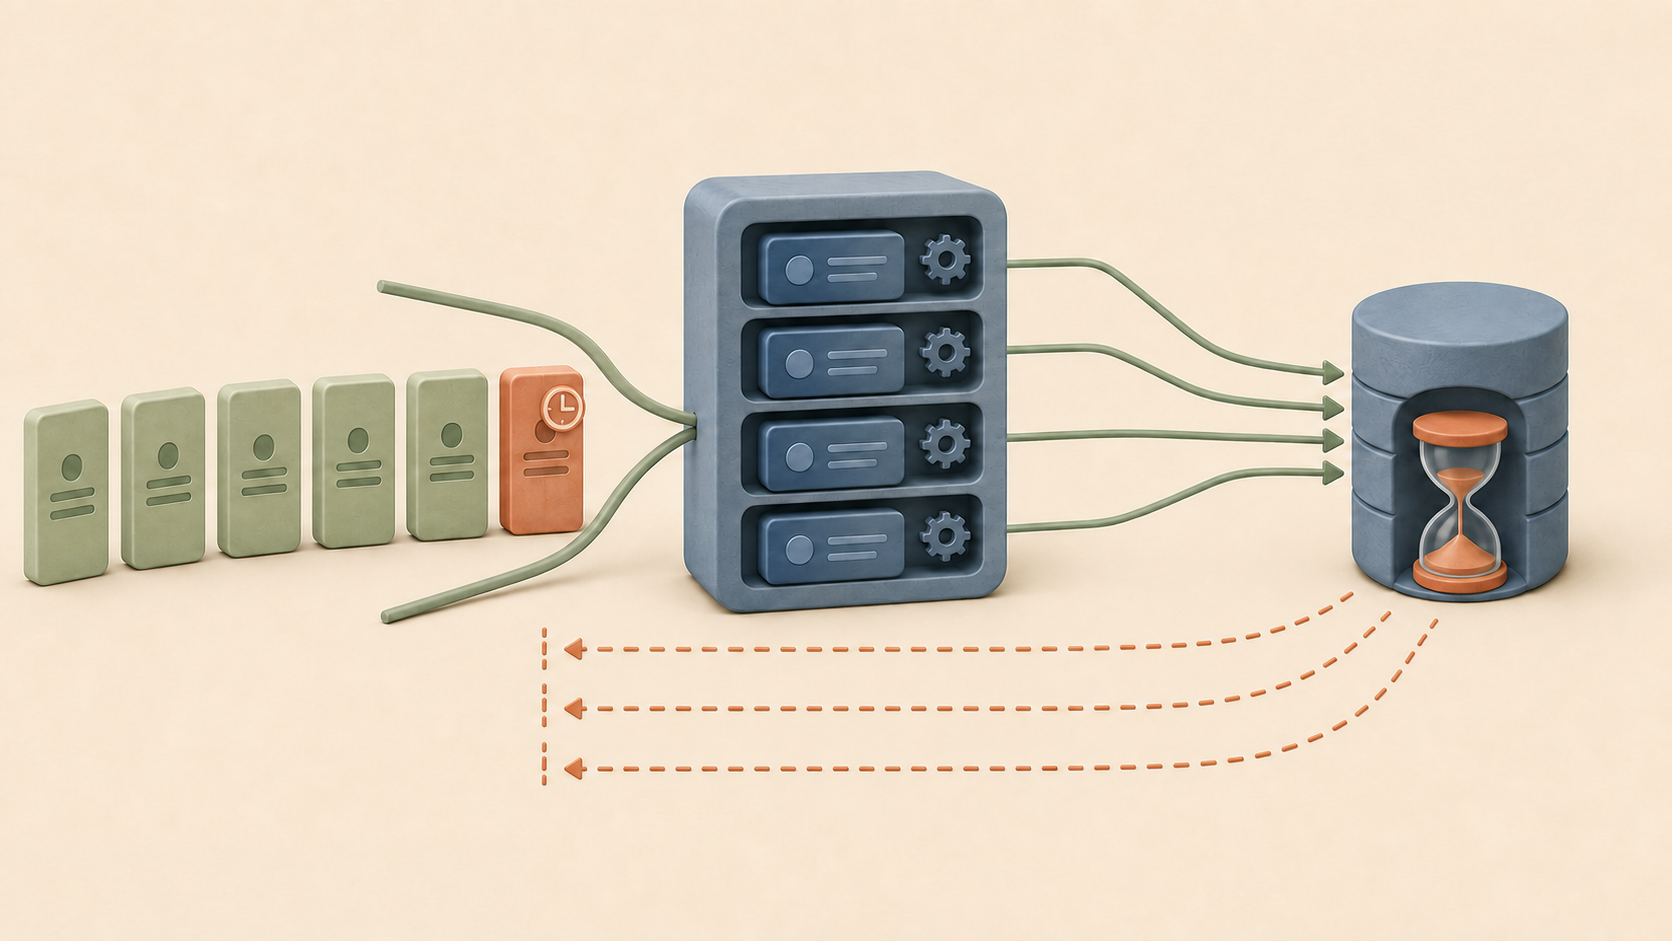
Когда сайт отвечает 504, я сначала выясняю, где запрос потерял время. Увеличить ожидание NGINX легко, но это может оставить пользователей ждать ещё дольше, а процессы PHP — держать соединения с базой. Чтобы обоснованно менять пул, мне нужна совпадающая по времени цепочка: запрос дошёл до нужного FastCGI upstream, свободные обработчики закончились, появилась очередь, а занятые процессы действительно выполняют или ждут работу.
Я — Семёнов Евгений Сергеевич, технический директор IT Fresh. Ниже разбираю рабочий порядок для одного пула PHP-FPM: от локализации задержки до небольшой обратимой правки. Цель — вернуть успешное выполнение нужной пользователю операции и удержать очередь в допустимых пределах при обычной нагрузке. Исчезновение отдельной записи 504 ещё не означает, что задача решена.
Как подтверждаю исчерпание пула
Мне нужны несколько последовательных снимков FPM, а не фотография состояния после аварии. Смотрю active processes, idle processes, total processes, текущую listen queue и её исторический максимум. Одновременно сохраняю start time или start since: они помогают увидеть смену эпохи счётчиков. Нулевое число свободных процессов на одном снимке допустимо при коротком всплеске; повторяющаяся очередь вместе с занятым пулом и ухудшением ответов существенно усиливает гипотезу.
listen queue показывает текущее ожидание свободного процесса, max listen queue — достигнутый максимум, а listen queue len — допустимую длину очереди. max children reached сообщает, что предел процессов уже достигался; ненулевое значение само по себе не означает перегрузку сейчас. Я сопоставляю изменения накопительных показателей только внутри одной эпохи запуска. После перезапуска старый максимум нельзя сравнивать с новым как непрерывную серию. Поля статуса PHP-FPM.
Сильная рабочая картина выглядит так: во время проблемных ответов активность близка к фактическому пределу пула, свободных процессов нет, очередь держится или растёт, а slowlog показывает повторяющееся ожидание одной зависимости. Если свободные процессы есть и очередь стабильно пуста, ищу медленные отдельные запросы, неверный upstream или задержку вне этого пула. Когда опрос слишком редкий, отсутствие очереди в выборке не исключает коротких пиков; временно уменьшаю интервал умеренно, без частого тяжёлого полного статуса.
Отдельно проверяю режим pm. В static число процессов фиксировано, в dynamic оно меняется в заданных пределах, в ondemand процессы появляются по спросу. pm.max_children ограничивает одновременно обслуживаемые запросы, но ещё не описывает скорость реакции на всплеск. Если total processes заметно ниже разрешённого максимума, преждевременно объявлять этот максимум причиной: важны запуск работников и текущие настройки режима. Менять режим одновременно с пределом я не стану. Настройки управления процессами FPM.
Есть несколько ложных подтверждений, которые я проверяю отдельно. Успешная статическая страница проверяет NGINX, но может вообще не обращаться к PHP. Ответ из кеша также обходит проблемный участок. И наоборот, один тяжёлый отчёт может получить таймаут при свободных остальных работниках. Поэтому для сопоставления выбираю именно динамическую операцию, где проявляется задержка, и выясняю, проходила ли она в исследуемый пул. Проверка страницы входа не заменяет проверку поиска, если зависает поиск.
Другая ловушка — усреднение. Средняя задержка может почти не измениться, когда небольшая доля запросов стоит в очереди значительно дольше остальных. Сравниваю хвост распределения и количество проблемных запросов, сохраняя общий объём. При очень малой выборке процентиль нестабилен: тогда полезнее разобрать отдельные временные цепочки. Если часы приложения и NGINX расходятся, сначала учитываю смещение; иначе легко связать очередь с чужим эпизодом. При нескольких узлах не складываю счётчики пулов без указания узла и времени запуска.

Получаю статус без публичной диагностической страницы
Путь pm.status_path не превращает сокет FPM в HTTP-сервер. Команда curl http://127.0.0.1:9000/status не является правильным опросом FastCGI listener. HTTP-клиенту нужен отдельный HTTP-шлюз с fastcgi_pass, а для прямого обращения требуется FastCGI-клиент. Для ручного сбора на сервере я предпочитаю Unix-сокет: не приходится открывать порт или размещать статус в публичном виртуальном хосте.
Если статус обслуживается основным пулом, при занятости работников он сам может ждать. pm.status_listen создаёт отдельный внутренний пул для статусных запросов. Директива появилась в PHP 8.0; приведённая конфигурация предполагает PHP 8.3 и обязательную проверку бинарником этой версии. Она улучшает наблюдаемость, но не добавляет обработчиков пользовательским запросам. Возможности PHP 8.0, конфигурация FPM.
В существующей секции [www] файла /etc/php/8.3/fpm/pool.d/www.conf задаю уникальные путь и сокет. Не создаю вторую секцию с тем же именем и не добавляю дубли директив. Если выбранные имена уже используются, разбираюсь с владельцем конфигурации. Перед сохранением проверяю, что публичный PHP location не сможет передать статусный путь основному пулу: pm.status_path действует и там. Для этого в соответствующем публичном server добавляю точный запрет, проверяю NGINX и применяю его раньше включения статуса.
location = /fpm-status-local { return 404; }; /etc/php/8.3/fpm/pool.d/www.conf, внутри [www]
pm.status_path = /fpm-status-local
pm.status_listen = /run/php/php8.3-fpm-status.sockПорядок резервного копирования, теста и reload приведён ниже и относится также к этой подготовке. После неё проверяю права нового сокета через stat и getfacl, включая проход по каталогу /run/php. Не задаю 0666, не добавляю сборщик в группу с доступом к основному сокету и не применяю общий listen.acl_users ради одной метрики: эти настройки могут расширить доступ ко всему пулу.
Для автоматического сбора предполагаю заранее выделенную непривилегированную учётную запись fpm-observer, без интерактивного входа и дополнительных групп. Точечная ACL выдаёт ей чтение и запись только статусного сокета; основной сокет должен оставаться недоступным. Следующие команды предполагают наличие setfacl, getfacl и /usr/bin/cgi-fcgi из пакета libfcgi-bin. Если инструментов или выделенного пользователя нет, останавливаюсь и согласую штатную установку, не подменяя сборщик root-службой.
sudo stat /run/php/php8.3-fpm-status.sock
sudo getfacl -p /run/php/php8.3-fpm-status.sock
id fpm-observer
sudo setfacl -m u:fpm-observer:rw /run/php/php8.3-fpm-status.sock
sudo -u fpm-observer test ! -w /run/php/php8.3-fpm.sock
sudo -u fpm-observer env -i \
  SCRIPT_NAME=/fpm-status-local SCRIPT_FILENAME=/fpm-status-local \
  REQUEST_URI=/fpm-status-local REQUEST_METHOD=GET QUERY_STRING=json \
  /usr/bin/timeout 5s /usr/bin/cgi-fcgi -bind \
  -connect /run/php/php8.3-fpm-status.sock
Проверка недоступности основного сокета должна завершиться успешно; иначе прекращаю настройку и убираю лишние права. Ответ cgi-fcgi содержит заголовки и тело: это не готовый чистый JSON для передачи парсеру. Проверяю успешный статус, отделяю заголовки и только затем разбираю тело. При пересоздании сокета ACL может исчезнуть: её восстановление должно быть узким управляемым действием после reload с повторной проверкой, а пропажа доступа — отдельным сигналом мониторинга.
Не вывожу статус наружу даже временно. Проверяю публичный путь через штатный HTTPS без отключения проверки сертификата: он должен возвращать запрет или 404, а не метрики. Для удалённого мониторинга выбираю существующий защищённый канал и сохраняю аутентификацию. Режим full нужен лишь кратковременно администратору: он раскрывает сведения о запросах и путях, поэтому для постоянного сбора достаточно сводки. Ограничения доступа к статусу FPM.
Считаю бюджет перед увеличением числа процессов
Дополнительный работник нужен лишь тогда, когда есть ресурс для его работы. Из доступного лимита памяти сначала вычитаю потребности системы, NGINX, базы, кеша, фоновых заданий, других пулов и резерв на пики. Если служба ограничена cgroup, ориентируюсь и на этот предел: свободная память хоста не отменяет меньший лимит службы. Базовые наблюдения делаю несколько раз под характерной нагрузкой, а не только сразу после reload.
free -m
systemctl show php8.3-fpm -p MemoryCurrent -p MemoryMax
ps -eo pid,ppid,rss,args --sort=-rss | head -n 25
sudo journalctl -k --since '-30 min' --no-pager | rg -i 'oom|out of memory|killed process'
RSS удобен для первичной оценки, но сумма RSS процессов повторно учитывает общие страницы. PSS из /proc/PID/smaps_rollup распределяет общую память пропорционально; USS описывает частную часть. Ни один одиночный снимок не предсказывает пик тяжёлого отчёта. Смотрю разброс по работникам и операциям, различаю master и процессы нужного пула, учитываю прогрев и длительность жизни процессов. Измерение памяти только PHP-функцией не покрывает все расходы процесса и окружения.
Для ориентировочной верхней границы можно разделить остаточный бюджет пула на консервативную оценку памяти работника и округлить вниз. Но это не гарантия безопасного pm.max_children: общая память меняется нелинейно, возможны одновременные пики, а ограничителем могут стать CPU, соединения базы или её блокировки. Поэтому расчёт даёт границу для проверки, а не готовую настройку. Если запаса нет либо уже наблюдаются swap и OOM, увеличение пула откладываю.
Избыточный параллелизм способен ухудшить ситуацию: больше PHP-процессов одновременно ждут одну базу, удерживая больше памяти и соединений. Когда причина в медленной зависимости, сначала ограничиваю ненужную конкурентную работу штатным механизмом приложения или устраняю конкретную задержку. Не прерываю произвольно транзакции и не повторяю платежи для проверки. Для длительной операции отдельно рассматриваю фоновое выполнение с отслеживанием результата, если это допускает её смысл.
Для более точной выборки беру PID из строки нужного worker в ps, убеждаюсь, что процесс ещё существует и принадлежит этому пулу, затем читаю сводку памяти. Значение 12345 в следующей команде необходимо заменить выбранным PID; совпадение имени процесса без проверки аргументов недостаточно.
sudo rg '^(Rss|Pss|Private_Clean|Private_Dirty|Swap):' /proc/12345/smaps_rollupРаботник может завершиться между выбором и чтением, поэтому ошибка отсутствия файла не равна неисправности сервера. Сохраняю единицы измерения и время каждого снимка. Серию под тяжёлой операцией сравниваю с серией под обычными запросами; одна средняя величина скрывает дорогие ветви приложения. Если после увеличения числа процессов выросла общая память, но не пропускная способность, это важный отрицательный результат. Возвращаю предел и продолжаю искать задержку, вместо того чтобы ещё раз удваивать число работников.
Провожу одну небольшую правку и сохраняю путь назад
До изменения записываю исходный предел, режим пула, нагрузку, очередь, ошибки, задержку выбранной операции и запас памяти. Нужен интервал, включающий характерный всплеск, иначе сравнение получится слишком удобным. Для первого шага выбираю только одну причинно обоснованную настройку. Если ресурсы проверены и работники упираются в предел, допустим небольшой прирост pm.max_children; если зависимость тормозит, этот шаг не выбираю.
Например, переход с уже установленного 20 на 22 имеет смысл только после расчёта бюджета и проверки зависимости. Это размер пробного шага, а не рекомендация ставить двадцать процессов. В dynamic сохраняю согласованность pm.start_servers, pm.min_spare_servers и pm.max_spare_servers. Не увеличиваю одновременно таймауты и backlog: тогда исчезнет возможность понять, что помогло. Если конфиг управляется панелью, правку делаю в её поддерживаемом источнике.
Ниже последовательность для обычного пакетного файла. Выполняю её в одной административной сессии; путь резервной копии сохраняю в записи изменения. Копия делается перед каждой самостоятельной стадией, чтобы откат лимита не снимал уже проверенную защиту статуса. Перед reload проверяю все включаемые пулы, потому что служба перечитает общий конфиг.
backup_dir=$(sudo mktemp -d /root/fpm-change.XXXXXX)
sudo cp -a /etc/php/8.3/fpm/pool.d/www.conf "$backup_dir/www.conf"
sudoedit /etc/php/8.3/fpm/pool.d/www.conf
sudo /usr/sbin/php-fpm8.3 -t -y /etc/php/8.3/fpm/php-fpm.conf
# Продолжать только при успешном тесте и CanReload=yes:
sudo systemctl reload php8.3-fpm
sudo systemctl is-active php8.3-fpm
sudo journalctl -u php8.3-fpm --since '-5 min' --no-pager
При ошибке теста reload не выполняю. Если unit не поддерживает reload, не заменяю его автоматически на restart: нужно отдельное окно с оценкой прерывания запросов. Даже штатная перезагрузка конфигурации требует наблюдения за переходом работников и пересозданием сокетов. Изменение одной секции не делает воздействие службы изолированным от других пулов.
Для отката возвращаю ровно сохранённый файл, предварительно убеждаюсь, что после моей правки никто не внёс в него независимые изменения. При обнаружении таких изменений возвращаю только собственную директиву вручную, сохраняя чужую работу. Затем снова тестирую и применяю конфигурацию.
sudo cp -a "$backup_dir/www.conf" /etc/php/8.3/fpm/pool.d/www.conf
sudo /usr/sbin/php-fpm8.3 -t -y /etc/php/8.3/fpm/php-fpm.conf
# Только после успешного теста:
sudo systemctl reload php8.3-fpm
sudo systemctl is-active php8.3-fpm
Если откатывается именно настройка статуса, отдельно отзываю ACL сборщика командой sudo setfacl -x u:fpm-observer /run/php/php8.3-fpm-status.sock, пока сокет существует. Публичный запрет оставляю до отключения status path. Если добавлялся диагностический NGINX-журнал, убираю собственную директиву и отдельный файл формата после проверки отсутствия ссылок на него, затем выполняю nginx -t и reload. Откат настроек не отменяет уже обработанные запросы, записи в базе и внешние операции.
Два вопроса после восстановления
Нужно ли обнулять max children reached, когда сайт снова работает?
Я не перезапускаю FPM ради красивого счётчика. Сохраняю время запуска и оцениваю новые изменения вместе с текущей очередью. Историческое достижение предела полезно для анализа ёмкости, но не требует аварийного действия, если операция выполняется нормально и очередь рассасывается.
Почему нельзя просто продлить ожидание NGINX?
Более долгое ожидание может быть оправдано для предусмотренной долгой операции, когда проверены ресурсы и согласован пользовательский сценарий. При занятом пуле оно не освобождает работников и не ускоряет зависимость. Сначала я устанавливаю причину задержки; затем отдельно согласую лимиты ожидания приложения, зависимостей и шлюза.
Источники и границы применимости
- https://www.php.net/manual/en/install.fpm.configuration.phpОфициальный источник для проверки материала.
- https://www.php.net/manual/en/fpm.status.phpОфициальный источник для проверки материала.
- https://nginx.org/en/docs/http/ngx_http_fastcgi_module.htmlОфициальный источник для проверки материала.
- https://nginx.org/en/docs/http/ngx_http_upstream_module.htmlОфициальный источник для проверки материала.
- https://www.php.net/manual/en/migration80.new-features.phpОфициальный источник для проверки материала.
Если причину 504 не удаётся найти
Если самостоятельно связать ошибки с очередью и безопасно восстановить обработку запросов не получается, свяжитесь со мной. Разберём маршрут запроса, состояние пула и ограничения инфраструктуры, затем определим следующий проверяемый шаг.