Границы материала
В статье я разбираю, как связываю доступность магазина с состоянием PHP-FPM, базы данных, Redis и фоновых заданий. Пороги, интервалы, пути и состав метрик подбираю под конкретный магазин и проверяю до включения оповещений.
Официальная документация проверена 2026-09-03. Примеры рассчитаны на современный WordPress, WooCommerce с Store API, Action Scheduler, PHP-FPM, MySQL либо MariaDB, Redis и Zabbix current (7.4 на дату проверки), но не являются непосредственно импортируемым production-шаблоном. Перед применением я сверяю версии, доступные команды, права, схему хранения и фактическую архитектуру.
Введение
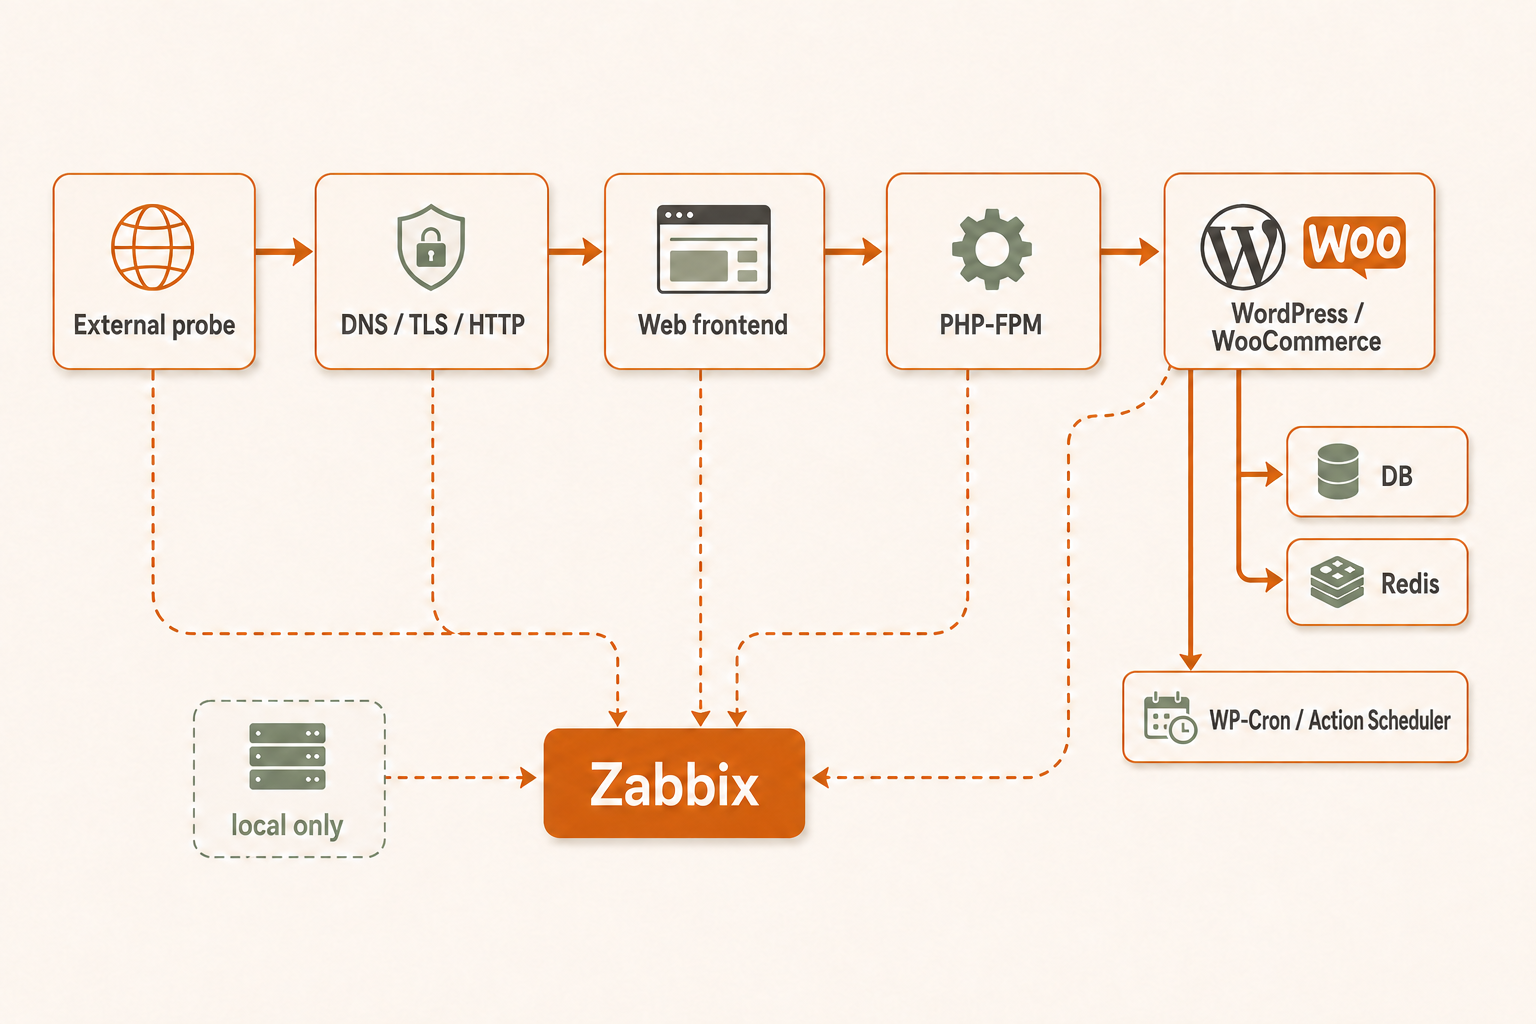
- Когда главная страница магазина отдаёт 200, я ещё не считаю WordPress и WooCommerce здоровыми. Покупатель может не открыть каталог, карточка — не получить цену, корзина — потерять сессию, checkout — зависнуть до создания заказа, а фоновые задачи — копить просрочку. Поэтому я начинаю не с количества метрик, а с пути пользователя и причинной цепочки: внешний DNS и TLS → HTTP и веб-сервер → PHP-FPM → WordPress/WooCommerce; база и Redis — зависимости приложения, WP-Cron и Action Scheduler — отдельная ветка фоновых заданий.
- Для каждого слоя я держу один и тот же цикл: решение → сигналы → проверка → rollback. Это дисциплинирует изменения. Синтетическая проверка отвечает, способен ли наш контролируемый клиент пройти безопасный маршрут сейчас. Реальная бизнес-метрика отвечает, что происходило с настоящими сессиями, оплатами и заказами. Первое нельзя выдавать за второе, а второе нельзя собирать так, чтобы раскрывать персональные данные или создавать заказ.
- Дальше я подробно показываю порядок настройки, ключи метрик и примеры выражений. Их нельзя импортировать вслепую как готовый production YAML/XML: сначала я подтверждаю версии компонентов, допустимую частоту опроса, точки доступа и нормальную нагрузку конкретного магазина.
1. Начинаю с границы сервиса и карты отказов
- Решение. Я описываю магазин как набор наблюдаемых контрактов. Внешний контракт — домен разрешается, цепочка сертификата валидна, редиректы ведут на канонический HTTPS, страницы отвечают вовремя и содержат устойчивый маркер. Прикладной контракт — REST index доступен согласно политике сайта, каталог отдаёт продукты, корзина сохраняет состояние одной синтетической сессии, checkout отображается без отправки формы. Внутренний контракт — у FPM есть свободная ёмкость, база отвечает на лёгкий read-only запрос, Redis не вытесняет ключи неожиданно, планировщики не накапливают просроченную работу.
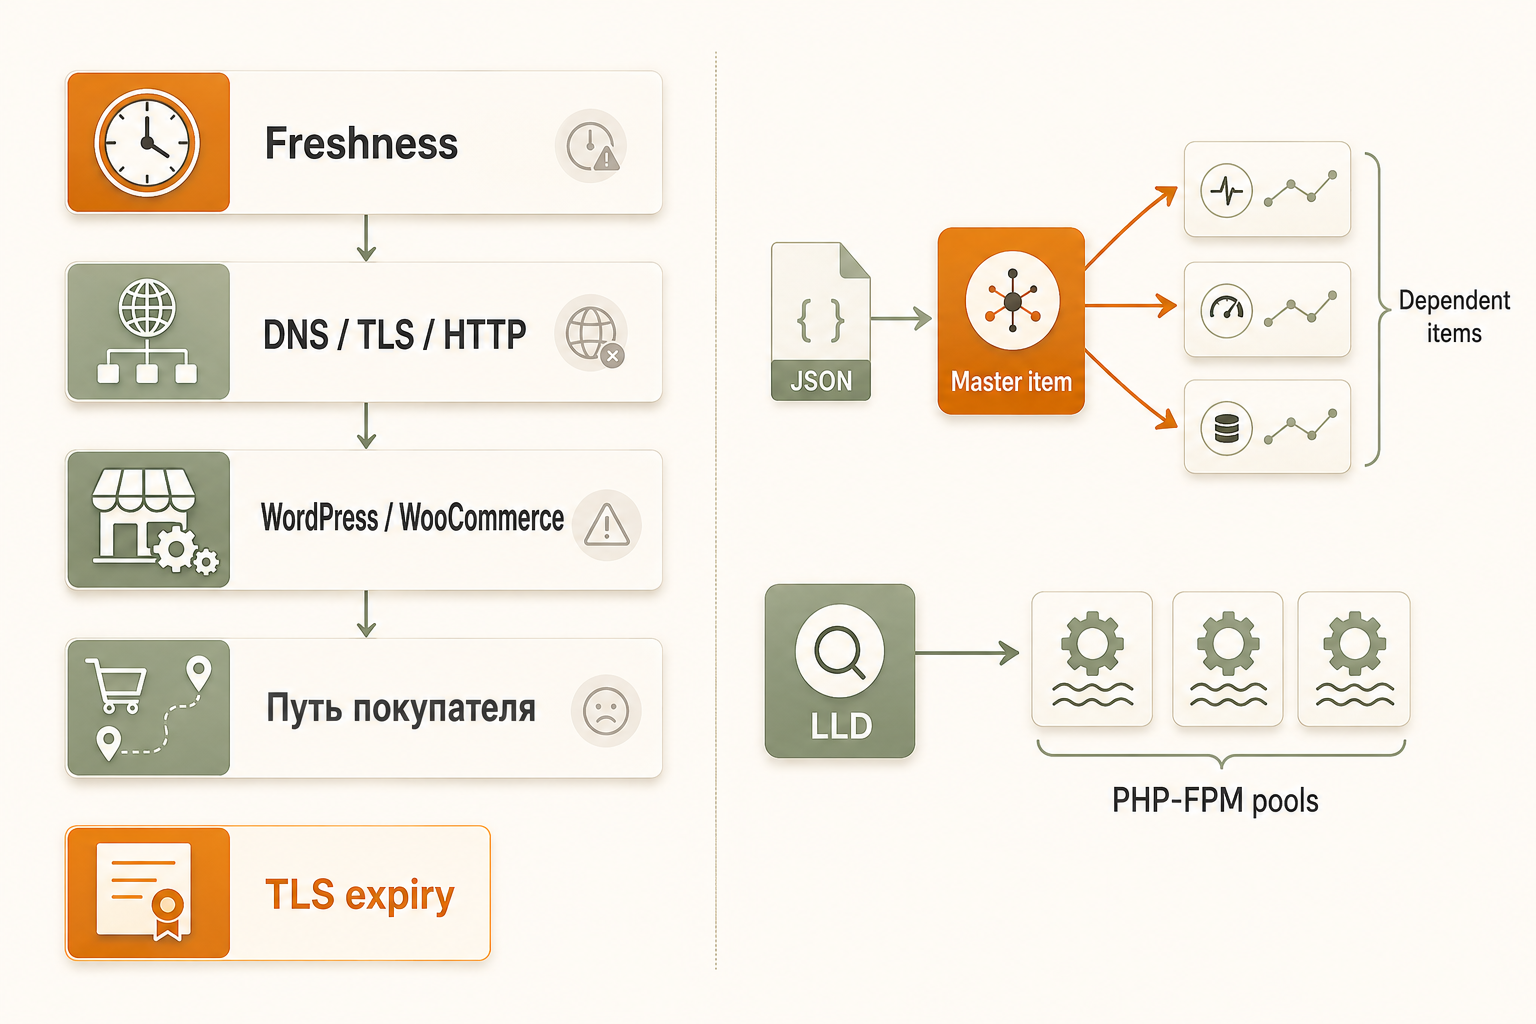
- Сигналы я делю на четыре уровня. Уровень L0 — свежесть самого сбора: `nodata()`, unsupported item, ошибка preprocessing. L1 — транспорт: DNS, TCP, TLS, HTTP status, redirect chain. L2 — приложение: content marker, REST/Store API, PHP-FPM, DB, Redis. L3 — предметный результат: реальный поток checkout и заказов, возраст и состояние очереди, ошибки платёжных интеграций из уже существующей observability. Эта иерархия нужна не для красоты: если L1 упал, десять событий L2 обычно лишь каскад.
- Проверка. Перед созданием триггеров я рисую причинный граф и для каждого события записываю независимый read-only тест. Rollback. Если новый probe меняет сессию, вызывает заметную нагрузку, возвращает персональные данные или нестабилен между версиями, я отключаю item, сохраняю обезличенный ответ для разбора и возвращаюсь к более узкому контракту.
Source ids
К разделу: 3 Trigger dependencies
2. Пользовательский путь: до checkout, но без заказа
- Решение. В web scenario или Browser item я прохожу главную, каталог, заранее выбранную опубликованную карточку, корзину и страницу checkout. Для простого HTTP-сценария каждая ступень — GET с проверкой ожидаемого status, времени и стабильного маркера. Для корзины нужен отдельный контролируемый сеанс: Store API использует cookie-based customer session, а изменяющие корзину endpoint требуют nonce/token механизма. Такой сценарий я запускаю только для выделенного дешёвого тестового товара, на отдельной синтетической cookie jar и с явным удалением товара из корзины в конце. Он не нажимает Place order, не вызывает `POST /checkout`, не резервирует склад и не обращается к боевому платёжному шлюзу.
- Безопасный минимум можно проверить без записи: `curl --fail-with-body --silent --show-error --location --max-redirs 5 --connect-timeout 3 --max-time 10 --proto '=https' --tlsv1.2 'https://SHOP.EXAMPLE/' -o /dev/null`; затем те же GET для `/shop/`, разрешённой карточки и `/checkout/`. Placeholder `SHOP.EXAMPLE` обязателен к замене. Для контроля origin после миграции использую `curl --resolve 'SHOP.EXAMPLE:443:203.0.113.10' 'https://SHOP.EXAMPLE/'`: URL сохраняет правильный Host и SNI, а тестовый IP заменяется на фактический. Опция `-k` запрещена, потому что она маскирует TLS-проблему.
- Сигналы: результат DNS с двух независимых резолверов; срок и имя в сертификате; число и адреса редиректов; HTTP status; TTFB и полное время; размер ответа; обязательный маркер страницы; отсутствие известных шаблонов maintenance/error. На карточке я проверяю не конкретную цену, которая меняется, а устойчивый элемент товара. На checkout — форму/блок и отсутствие серверной ошибки, но не создаю заказ.
- Проверка. Один и тот же маршрут запускаю из внешнего Zabbix proxy и при необходимости из внутренней точки. Сравниваю внешний результат с origin через `--resolve`, чтобы отделить DNS/CDN/WAF от приложения. Частоту выбираю с учётом кэша и стоимости динамических страниц; checkout не опрашиваю каждую секунду. Rollback — отключить сценарий и удалить только его синтетическую сессию. Если магазин не допускает изменение корзины, оставляю GET-путь и использую одобренный staging/canary для stateful шага.
- Реальные бизнес-метрики веду отдельно: количество начатых checkout, созданных заказов, распределение итоговых статусов, ошибки оплаты и время переходов между статусами — только из уже согласованного аналитического или серверного контура, агрегированно и без customer/order payload. Ноль реальных заказов не равен аварии без календаря продаж и бизнес-контекста; успешная синтетика не доказывает, что реальная оплата проходит.
Source ids
К разделу: WooCommerce Store API | WooCommerce developer docs
3. WordPress: Site Health, REST API и WP-Cron
- Решение. Для WordPress я беру три независимых признака. Первый — публичный REST discovery `/wp-json/`, если он разрешён политикой сайта. Второй — узкие Site Health REST tests, например loopback/HTTPS, через отдельную аутентифицированную учётную запись с capability `view_site_health_checks`. Третий — расписание cron локальным WP-CLI без принудительного запуска. Публичный REST может быть намеренно закрыт или изменён security-плагином; в таком случае 401/403 — ожидаемый контракт, а не универсальная авария.
- Безопасная команда расписания: `sudo -u WP_OWNER -- wp --path=/srv/www/SHOP cron event list --fields=hook,next_run_gmt,next_run_relative,recurrence --format=json`. Здесь `WP_OWNER` и путь — placeholders, а правило sudo должно разрешать фиксированный wrapper без произвольных аргументов. Site Health вызываю HTTP agent по конкретным GET endpoints `/wp-json/wp-site-health/v1/tests/loopback-requests` и `/https-status`; Application Password хранится в secret/vault macro и не печатается. `cron event list` читает расписание; я не подменяю его `wp cron event run --all`, потому что последнее выполняет задачи и может создать нагрузку или изменить данные.
- WP-Cron не является постоянно работающим daemon: WordPress проверяет очередь при загрузках страниц. Функция `spawn_cron()` инициирует неблокирующий HTTP request к `wp-cron.php`, применяет lock и не должна запускаться чаще ограничения lock. Поэтому я наблюдаю не только наличие событий, но и самое старое просроченное событие, возраст успешного выполнения известного безопасного hook (если приложение уже пишет такой сигнал), ошибки loopback/spawn и фактическую схему: page-load spawning либо системный scheduler при `DISABLE_WP_CRON`.
- Проверка. Я сопоставляю `next_run_gmt`, системное время, ошибки Site Health loopback и журнал планировщика. Отсутствие трафика объясняет задержку штатного WP-Cron; при системном cron проверяю owner, рабочий каталог, PHP binary и расписание, но не запускаю все hooks для теста. Rollback изменений планировщика: вернуть прежний механизм и значение `DISABLE_WP_CRON`, восстановить прежнюю запись scheduler и убедиться, что одновременно не работают два владельца запуска.
Source ids
К разделу: Cron – Plugin Handbook | Developer.WordPress.org; spawn_cron() – Function | Developer.WordPress.org; wp cron event list – WP-CLI Command | Developer.WordPress.org; Authentication – REST API Handbook | Developer.WordPress.org; Wp Site Health Tests – REST API Handbook | Developer.WordPress.org; 4 Secret user macros
4. WooCommerce API и очередь заказов
- Решение. Публичный Store API применяю для read-only проверки каталога, например `GET /wp-json/wc/store/v1/products?per_page=1`; он предназначен для customer-facing product/cart/checkout и не требует API keys для публичного чтения. Изменяющие endpoints корзины работают в контексте клиентской сессии и требуют корректных tokens. Административный WooCommerce REST API отделяю полностью: consumer key/secret получает минимальные read-права, передаётся только по HTTPS и не попадает в URL, argv, item history или debug log.
- Для authenticated проверки я предпочитаю HTTP agent с Zabbix secret/vault macros в полях credentials либо локальный wrapper, читающий root-owned credential file/secret store. Команда с `curl -u USER:SECRET` в расписании неприемлема: секрет виден в argv. Для разовой ручной проверки вне Zabbix безопаснее `curl --config /run/credentials/woocommerce-monitor.curl ...`, где файл доступен только сервисному пользователю; реальное имя и права определяются инфраструктурой.
- Очередь WooCommerce обычно обслуживает Action Scheduler, но я не предполагаю одну таблицу и один набор колонок. Версия, data store и префикс БД различаются; прямой SQL по `wp_actionscheduler_actions` хрупок. Сначала проверяю доступные команды `wp action-scheduler --help` и использую официальный WP-CLI интерфейс там, где он установлен. Считаю pending, failed и overdue, причём overdue — это pending action с запланированным временем в прошлом по принятой политике, а не отдельный универсальный status. Дополнительно полезны возраст старейшей pending-задачи, свежесть последнего complete и группировка по hook/group с allow-list, чтобы не экспортировать аргументы действий.
- Сигналы очереди требуют контекста. Один failed action — доказательство ошибки действия, но не обязательно недоступность checkout; растущий backlog и возраст старейшей due action важнее голого количества. Я связываю их с WP-Cron/runner, PHP-FPM, БД и журналом конкретного hook. Trigger не должен включать payload заказа или customer data.
- Проверка — повторный read-only list/count через WP-CLI и сверка с экраном Scheduled Actions для уполномоченного администратора. Я не запускаю массово pending actions и не удаляю failed actions ради зелёного графика. Rollback collector — выключить wrapper/item и вернуть прежние права; очередь не модифицируется. Исполнение или очистка — отдельная change-процедура с владельцем WooCommerce.
Source ids
К разделу: WooCommerce Store API | WooCommerce developer docs; WooCommerce REST API | WooCommerce developer docs; WP CLI | Action Scheduler - Job Queue for WordPress; 4 Secret user macros
5. PHP-FPM: status и ping с минимальной экспозицией
- Решение. В каждом нужном pool включаю `pm.status_path` и при необходимости `ping.path`, но публикую их только через защищённый HTTP location web-сервера, доступный на loopback, либо через иной явно ограниченный HTTP proxy. Сам Unix socket PHP-FPM и `pm.status_listen` говорят по FastCGI, а не по HTTP: `curl` к ним напрямую не обращается. Никогда не выставляю full status наружу: он способен показать URI и параметры текущих запросов. Если основной pool забит, отдельный `pm.status_listen` может дать независимый FastCGI status listener; применимость сверяю с установленной версией PHP.
- Master item забирает JSON status одним локальным запросом. Dependent items извлекают `accepted conn`, `listen queue`, `max listen queue`, `idle processes`, `active processes`, `total processes`, `max active processes`, `max children reached` и `slow requests`. Счётчики `max children reached` и `slow requests` накопительные: для интенсивности применяю change per second или delta с обработкой рестарта pool, а не тревожусь на вечное значение больше нуля.
- Предварительное условие проверки — сначала настроить в nginx или Apache локальный HTTP listener, привязанный только к `127.0.0.1:<FPM_STATUS_HTTP_PORT>`, и location `/fpm-status`, который передаёт запрос по FastCGI в фактический `listen` нужного FPM pool. `<FPM_STATUS_HTTP_PORT>`, путь, FastCGI socket/host:port и параметры `SCRIPT_FILENAME`/`SCRIPT_NAME` — обязательные placeholders: их определяю по реальной конфигурации, проверяю allow-list и не считаю порт заранее существующим. После validation web-сервера и PHP-FPM проверка выглядит так: `curl --fail --silent --show-error --max-time 5 'http://127.0.0.1:8081/fpm-status?json'`, где `8081` — только пример значения `<FPM_STATUS_HTTP_PORT>`. Сначала подтверждаю HTTP status, JSON schema и отсутствие доступа не с loopback; `curl` не направляю в FastCGI socket. Ping доказывает ответ FPM, но не работоспособность WordPress. Rollback: удалить локальный HTTP include/location и вернуть прежнюю конфигурацию pool после config test и контролируемого reload; если validation не проходит, конфигурацию не применяю.
Source ids
К разделу: PHP: Status Page - Manual; PHP: Configuration - Manual
6. MySQL/MariaDB: лёгкий read-only контроль
- Решение. Отдельная monitoring account получает только необходимые права и доступ с локального host/socket. Connectivity проверяю коротким `SELECT 1`; состояние — узким набором status variables: Threads_connected, Threads_running, Connections, Aborted_connects, Max_used_connections и, если настроено, счётчиками slow queries. Пароль не передаю как `-pSECRET`: клиент читает защищённый `--defaults-extra-file` или credential store.
- Копируемый безопасный пример: `mysql --defaults-extra-file=/run/credentials/db-monitor.cnf --connect-timeout=3 --batch --skip-column-names -e 'SELECT 1'`. Это лёгкий read-only запрос; путь примерный, файл должен иметь минимальные права. Для replication, только если она реально есть, наблюдаю receiver/applier, last error и lag-показатель с оговоркой о его семантике. В MySQL Performance Schema replication tables удобнее для программного чтения и multithreaded workers; MariaDB имеет отличия, поэтому запрос выбираю по продукту и версии.
- Сигналы интерпретирую вместе: высокая доля Threads_running относительно проверенной ёмкости, рост aborted connections, исчерпание connection budget, рост slow-query counter и replication errors. Для connection budget master `db.status` должен вернуть числовые `Threads_connected` и `max_connections`. Из них создаю dependent item `db.connection_utilization` типа Numeric (float), единицы `%`: preprocessing проверяет оба поля, отклоняет отсутствующие или нечисловые значения, при `max_connections<=0` делает item unsupported с явной ошибкой, а иначе возвращает `100*Threads_connected/max_connections`. Альтернатива — calculated item по реальным item paths, например `100*last(//db.threads_connected)/last(//db.max_connections)`, но отдельное правило должно не допустить расчёт при неположительном знаменателе. Ошибку сбора или знаменателя не заменяю нулём: её контролирует отдельный nodata/unsupported trigger. `{$DB.CONN.PCT}` задаю в тех же процентных единицах, например `80` означает 80%, а `{$DB.WINDOW}` — временной placeholder вроде `5m`, выбранный по baseline. Полный PROCESSLIST и тексты slow log не отправляю в Zabbix: там могут быть SQL literals и персональные данные. Проверка — тот же read-only запрос локально, error log и ограниченная Performance Schema выборка. Rollback — отозвать monitoring grant и удалить credential file после отключения items; никаких FLUSH, ANALYZE или тяжёлых full-table probes мониторинг не выполняет.
Source ids
К разделу: MySQL :: MySQL 8.4 Reference Manual :: 7.1.10 Server Status Variables; MySQL :: MySQL 8.4 Reference Manual :: 29.12.11 Performance Schema Replication Tables; 15 Dependent item; 14 Calculated item
7. Redis: доступность, память и качество object cache
- Решение. Redis опрашивает локальный agent/wrapper по Unix socket или защищённому TCP. `PING` подтверждает способность обработать команду, `INFO` отдаёт группы статистики. Не публикую Redis в Интернет. При TCP учитываю ACL с отдельным read-only пользователем, AUTH, TLS и сетевое ограничение; даже secret macro не компенсирует открытый порт.
- Собираю `used_memory`, `maxmemory`, `evicted_keys`, `keyspace_hits`, `keyspace_misses`, `blocked_clients`, `connected_clients`, `rejected_connections`, uptime и роль. Hit ratio рассчитываю как hits/(hits+misses) только при ненулевом знаменателе и оцениваю по окну/delta: накопительный lifetime ratio скрывает свежую деградацию. Evictions также превращаю в скорость и связываю с `maxmemory`/policy. Если `maxmemory=0`, процент заполнения к нему не вычисляю.
- Безопасная форма для ACL без секрета в argv: `REDISCLI_AUTH` тоже может утечь через окружение процесса, поэтому для постоянного сбора я предпочитаю локальный защищённый config/agent plugin или Unix socket с файловыми правами. Иллюстративно без аутентификационных данных: `redis-cli -s /run/redis/redis.sock --no-auth-warning PING` и `redis-cli -s /run/redis/redis.sock --no-auth-warning INFO memory`. Проверка — PING, узкие INFO sections и WordPress object-cache diagnostics, если они уже доступны. Rollback — отключить collector и удалить только созданного monitoring ACL user/правило после проверки отсутствия потребителей; данные Redis не очищать.
Source ids
К разделу: INFO | Docs; PING | Docs; ACL | Docs; 4 Secret user macros
8. Как я собираю это в Zabbix
- Решение. На каждую подсистему создаю один master item с компактным JSON и dependent items с JSONPath. Историю сырого master обычно не храню либо держу очень коротко; числовые dependent items получают разумную history, а trends — только там, где долгий агрегат полезен. Dependent items наследуют момент и частоту master item. JSONPath сначала тестирую на обезличенном образце ответа и задаю явную обработку ошибок, чтобы изменение схемы стало отдельным событием, а не нулём.
- LLD использую только для изменяемого множества: FPM pools, сайты multisite или Action Scheduler groups из allow-list. Пять фиксированных ступеней customer journey не нуждаются в discovery. Макросы задают URL, proxy, intervals и пороги; чувствительные значения — Secret text или Vault. Я помню, что секретный macro скрывает отображение, но Zabbix всё равно подставляет значение, поэтому не допускаю его попадания в item value, error text или script output.
- Теги `service=storefront|wordpress|php-fpm|db|redis|scheduler`, `scope=external|origin|local`, `signal=availability|latency|capacity|backlog|freshness` делают маршрутизацию и корреляцию явными. Value maps применяю к ограниченным состояниям (`up/down/unknown`, role), но не маскирую ими сырые ошибки. Частоту и timeout развожу: внешний homepage чаще, динамический checkout реже, локальные status — умеренно; timeout меньше интервала и меньше периода подавления. Универсальные числа ниже — стартовая иллюстрация, не SLA.
Матрица элементов
Key Type Interval Preprocessing Units Note store.journey.step[home]
Web/Browser dependent
{$JOURNEY.INTERVAL} (например 1m)
JSONPath $.steps.home.status/latency/content
bool, ms
GET, no write
store.journey.step[checkout]
Dependent
master (например 5m)
JSONPath $.steps.checkout.*
bool, ms
не отправлять order
wp.site_health
Zabbix agent wrapper master
{$WP.HEALTH.INTERVAL}
JSON validation
JSON
history off/short
wp.cron.oldest_overdue
Dependent
WP master
JSONPath + timestamp delta
s
read-only list
wc.store.products
HTTP agent
{$WC.API.INTERVAL}
HTTP status + JSONPath
bool
public GET
wc.as.pending
Dependent
{$AS.INTERVAL}
JSONPath $.pending
actions
schema/version checked
wc.as.oldest_due_age
Dependent
AS master
JSONPath $.oldest_due_age
s
preferred over count alone
php.fpm.get[{#POOL}]
Agent master prototype
{$FPM.INTERVAL}
JSON validation
JSON
local endpoint
php.fpm.listen_queue[{#POOL}]
Dependent prototype
FPM master
JSONPath $['listen queue']
requests
LLD only for real pools
db.status
Agent/DB monitor master
{$DB.INTERVAL}
JSON validation
JSON
least privilege
db.threads_running
Dependent
DB master
JSONPath $.Threads_running
threads
baseline threshold
db.connection_utilization
Dependent (or Calculated)
DB master
100*Threads_connected/max_connections; reject missing/non-numeric; unsupported if max_connections<=0
%
Numeric (float); {$DB.CONN.PCT} is percent; errors are not zero
redis.info
Agent/plugin master
{$REDIS.INTERVAL}
text-to-JSON wrapper
JSON
local/protected
redis.evictions.rate
Dependent
Redis master
JSONPath $.evicted_keys; change per second
evictions/s
handle restart
redis.hit_ratio.window
Calculated
{$REDIS.INTERVAL}
delta hits/(delta hits+delta misses)
%
guard zero denominator
Source ids
К разделу: 15 Dependent item; 4 JSONPath functionality; Low-level discovery; 4 Secret user macros; History and trends; 14 Calculated item
9. Матрица событий и подавление каскадов
- Я назначаю severity по влиянию и срочности конкретного магазина. Ниже `Warning/High/Disaster` — не универсальная шкала, а проектная заготовка. Каждое событие содержит operational data: какую независимую проверку выполнить, где искать владельца и какой сигнал должен восстановиться.
Матрица триггеров
Event Expression example Severity Depends on Verification Нет свежих данных master item
nodata(/TEMPLATE/key,{$COLLECTOR.NODATA})=1
Warning
agent/proxy unavailable
проверить last error, wrapper и schema
Публичный HTTPS недоступен
max(/TEMPLATE/store.journey.step[home],#3)=0
High
DNS failure; proxy/network failure
внешний curl и origin через --resolve
Checkout не открывается
max(/TEMPLATE/store.journey.step[checkout],#2)=0
High
homepage/HTTP root failure
GET checkout без submit, затем PHP/DB
FPM listen queue устойчиво растёт
min(/TEMPLATE/php.fpm.listen_queue[pool],{$FPM.WINDOW})>{$FPM.QUEUE.MAX}
High
FPM down; collector unavailable
локальный status и web latency
Action Scheduler просрочен
min(/TEMPLATE/wc.as.oldest_due_age,{$AS.WINDOW})>{$AS.OVERDUE.MAX}
Warning/High
WP-Cron runner failure; DB down
read-only WP-CLI list и hook logs
DB connection budget близок к пределу
min(/TEMPLATE/db.connection_utilization,{$DB.WINDOW})>{$DB.CONN.PCT}
High
DB collector unavailable; db.connection_utilization unsupported
проверить Threads_connected, max_connections>0, вычисленный процент и единицы macro
Redis evictions появились
min(/TEMPLATE/redis.evictions.rate,{$REDIS.WINDOW})>{$REDIS.EVICT.RATE}
Warning
Redis unavailable
INFO memory/stats, maxmemory policy
TLS скоро истекает
last(/TEMPLATE/tls.days_left)<{$TLS.DAYS.WARN}
Warning
нет зависимости от FPM/DB
внешний сертификат с правильным SNI
Source ids
К разделу: 2 Trigger expression; 3 Trigger dependencies; 14 Calculated item; 15 Dependent item
10. Диагностика: иду снаружи внутрь
- Если магазин недоступен, я не начинаю с рестарта PHP. Порядок такой: (1) свежесть Zabbix proxy/agent и время; (2) DNS у независимых резолверов; (3) TCP/TLS, SNI и redirect chain; (4) HTTP status, latency и content; (5) тот же origin через `--resolve`; (6) web server/upstream; (7) FPM ping/status и очередь; (8) лёгкий DB query и connections/threads; (9) Redis; (10) WordPress Site Health/REST; (11) WP-Cron и Action Scheduler; (12) уже существующие агрегированные order/payment сигналы.
- Типовые развилки: внешний probe падает, а origin здоров — смотрю DNS/CDN/WAF; origin даёт 502 и FPM ping не отвечает — проверяю pool/socket; FPM отвечает, но latency и Threads_running растут — исследую БД без тяжёлого запроса; страницы быстрые, но очередь стареет — проверяю runner, cron ownership и конкретные failed hooks. Так событие ведёт к проверке, а не к автоматическому опасному действию.
- Rollback диагностики прост: все probes по умолчанию read-only, интервалы можно увеличить, collector отключить. Я не лечу мониторингом: автоматический restart, очистка Redis, запуск всех cron events или retry всех заказных действий требуют отдельной одобренной процедуры.
Source ids
К разделу: PHP: Status Page - Manual; MySQL :: MySQL 8.4 Reference Manual :: 7.1.10 Server Status Variables; INFO | Docs; Wp Site Health Tests – REST API Handbook | Developer.WordPress.org; wp cron event list – WP-CLI Command | Developer.WordPress.org; WP CLI | Action Scheduler - Job Queue for WordPress; 3 Trigger dependencies
11. Поэтапная миграция старого WordPress/PHP/MySQL
- Решение начинается с inventory: версии ОС, web server, PHP и extensions, WordPress/WooCommerce/plugins/theme, table engine/charset/collation, DB size, uploads, object/page cache, session/cart storage, cron, Action Scheduler runner, SMTP/payment/webhooks, certificates, vhost redirects, filesystem ownership и внешние интеграции. Затем составляю compatibility matrix и отдельно отмечаю всё, что не подтверждено производителем.
- До окна работ делаю backup файлов и БД и обязательно restore rehearsal на изолированном адресе. Проверяю checksum/число файлов, импорт БД, URL/config, PHP startup, wp-admin, REST, каталог, корзину и checkout без заказа. Новый сервер получает TLS/vhost, но тестируется через `--resolve`. Кэши и sessions планирую явно: object cache нельзя просто считать переносимым источником истины; ключевой namespace/salt и политика очистки должны исключить столкновение старого и нового origin.
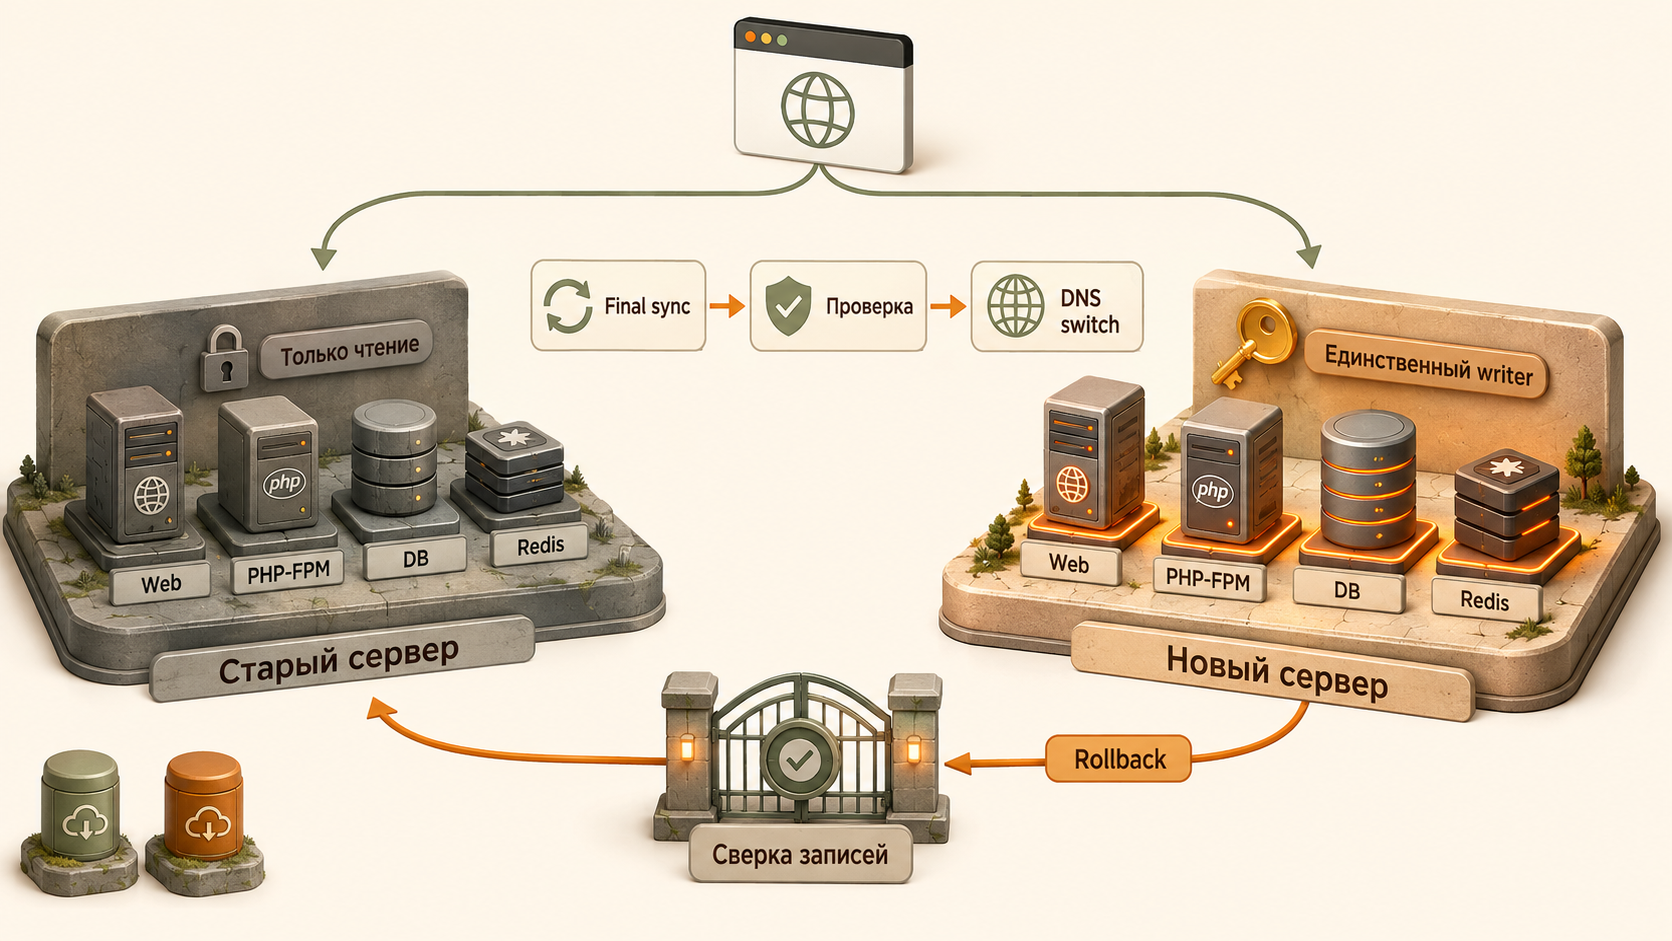
- Первичный files/db sync выполняю заранее. На финальном окне включаю согласованный maintenance или read-only режим на уровне приложения, который действительно блокирует записи, а не только рисует заглушку. Останавливаю старого владельца cron/workers/Action Scheduler, делаю final delta файлов и консистентный DB dump/replication cutover по выбранной технологии, восстанавливаю на новом сервере, проверяю owner/permissions и только затем запускаю единственного владельца cron и workers на новом.
- Перед DNS switch gate включает: успешный restore, совместимость, TLS/vhost, локальный journey, DB/Redis, cron ownership, очередь без неожиданного роста, логи без новых критичных ошибок и готовый rollback. Низкий TTL помогает только если был снижен заблаговременно и резолверы его соблюдают; он не гарантирует мгновенное переключение. После go меняю DNS и фиксирую точное время/значения.
Source ids
К разделу: Cron – Plugin Handbook | Developer.WordPress.org; WP CLI | Action Scheduler - Job Queue for WordPress; PHP: Configuration - Manual; MySQL :: MySQL 8.4 Reference Manual :: 7.1.10 Server Status Variables; INFO | Docs
12. Контроль после DNS и защита от split-brain
- Сигналы после переключения беру из нескольких перспектив. Проверяю authoritative answer и независимые recursive resolvers, старый и новый origin через `--resolve` с тем же HTTPS hostname/SNI, публичные HTTP/TLS/redirect/content, весь безопасный user journey, FPM, DB, Redis, logs и очереди. Публичный DNS может вести разных клиентов на разные origin, поэтому на обоих узлах отслеживаю access и, главное, возможность записи.
- Заказы или другие записи для проверки создаются только через заранее одобренный canary с тестовым платёжным режимом и процедурой отмены либо не создаются вовсе. По умолчанию я использую существующую observability реальных операций, не читаю персональные payload и не оформляю тестовую покупку. Если старый и новый сервер одновременно принимают writes, объявляю split-brain: останавливаю rollout, определяю authoritative writer и не пытаюсь склеить базы импровизированными SQL-командами.
- Go/no-go оцениваю не по одному зелёному HTTP 200. Go — резолвинг и TLS ожидаемы, origin/journey стабилен в согласованном окне, writer единственный, очереди исполняются, ошибки не растут. No-go — потеря записей, два writer, несовместимость checkout/payment, неконсистентные sessions/cache, необъяснимый backlog или невозможность доказать состояние.
Source ids
К разделу: WooCommerce Store API | WooCommerce developer docs; PHP: Status Page - Manual; MySQL :: MySQL 8.4 Reference Manual :: 7.1.10 Server Status Variables; INFO | Docs; wp cron event list – WP-CLI Command | Developer.WordPress.org; WP CLI | Action Scheduler - Job Queue for WordPress
13. Rollback, который я готовлю до переключения
- Rollback — не фраза «вернуть DNS». Я заранее фиксирую точку невозврата и способ сохранить записи после cutover. Если новых подтверждённых writes ещё нет, можно остановить writer/workers на новом, вернуть writer ownership старому и обратить DNS. Если writes уже появились, простой откат DNS способен потерять заказы: сначала нужна согласованная reverse delta/reconciliation процедура или решение остаться на новом узле. Это отдельный go/no-go владельцев данных.
- При откате учитываю реальный TTL и кэши резолверов: часть клиентов продолжит ходить на новый IP. Оба origin должны корректно обслуживать TLS, а только один — принимать writes. Sessions/cart и Redis нельзя бездумно копировать или `FLUSHALL`: я либо использую заранее спроектированное общее/переносимое хранилище, либо принимаю документированную потерю синтетических сессий и защищаю реальные данные выбранной схемой.
- Я сохраняю evidence: timestamps DNS, ответы резолверов, обезличенные probe results, версии, deploy/config diff, DB positions/checksums, queue counts и логи вокруг окна. Старый сервер не уничтожаю, не переиспользую и не очищаю, пока не завершены период наблюдения, reconciliation, backup verification и формальная приёмка. После rollback повторяю DNS/TLS/journey, проверяю единственного writer, cron ownership, workers, DB/cache и очередь.
Source ids
К разделу: Cron – Plugin Handbook | Developer.WordPress.org; WP CLI | Action Scheduler - Job Queue for WordPress; MySQL :: MySQL 8.4 Reference Manual :: 7.1.10 Server Status Variables; INFO | Docs
Вывод
- Хороший мониторинг WooCommerce для меня — не коллекция графиков, а короткая доказуемая цепочка. Внешний путь показывает влияние на покупателя; FPM, база и Redis объясняют ресурсную причину; Site Health, REST, WP-Cron и Action Scheduler показывают прикладную работу; зависимости триггеров удерживают каскад под контролем. Любое изменение проходит решение → сигналы → проверку → rollback.
- Если вам не удаётся самостоятельно настроить или стабилизировать мониторинг WordPress и WooCommerce в Zabbix либо вы готовите перенос магазина, обращайтесь ко мне. Я помогу разобраться с причиной сбоев, а вместе с командой IT Fresh мы настроим контроль сайта, PHP-FPM, базы данных, Redis и фоновых очередей под вашу инфраструктуру. Напишите мне в [Telegram @ITfresh_Boss](https://t.me/ITfresh_Boss), позвоните [+7 903 729-62-41](tel:+79037296241) или оставьте заявку на [ITfresh.ru](https://itfresh.ru/).
Source ids
К разделу: Wp Site Health Tests – REST API Handbook | Developer.WordPress.org; WooCommerce Store API | WooCommerce developer docs; PHP: Status Page - Manual; MySQL :: MySQL 8.4 Reference Manual :: 7.1.10 Server Status Variables; INFO | Docs; 3 Trigger dependencies
Источники и границы применимости
- Cron – Plugin Handbook | Developer.WordPress.orgWP-Cron обрабатывает запланированные задачи WordPress; WP-Cron проверяет очередь при загрузках страниц и не работает постоянно как системный cron; При отсутствии загрузок страниц выполнение может задерживаться
- spawn_cron() – Function | Developer.WordPress.orgspawn_cron() посылает HTTP request для запуска cron без блокирования загрузки страницы; Функция использует cron lock и проверяет готовые jobs; Фактическое spawning зависит от констант и состояния lock
- wp cron event list – WP-CLI Command | Developer.WordPress.orgКоманда перечисляет scheduled cron events; Поддерживаются поля hook, next_run_gmt, recurrence и JSON output; Команда list пригодна для read-only inventory расписания
- Authentication – REST API Handbook | Developer.WordPress.orgWordPress REST API поддерживает cookie authentication с nonce; Application Passwords предназначены для API-доступа по HTTPS; Запрос требует capability соответствующего пользователя
- Wp Site Health Tests – REST API Handbook | Developer.WordPress.orgWordPress предоставляет REST endpoints для отдельных Site Health tests; Ответ включает test, status, badge, description и actions; Доступны, среди прочего, loopback-requests и https-status tests; endpoint требует соответствующей capability
- WooCommerce Store API | WooCommerce developer docsStore API предоставляет customer-facing endpoints для products, cart и checkout; Публичное чтение Store API не требует API keys; Customer sessions cookie-based; Изменяющие endpoints требуют nonce-token и способны изменять состояние корзины; Namespace — /wp-json/wc/store/v1
- WooCommerce REST API | WooCommerce developer docsWooCommerce REST API предназначен для административного доступа к данным магазина; Credentials следует передавать только по защищённому каналу и с минимальными правами; REST API отличается по назначению от публичного Store API
- WP CLI | Action Scheduler - Job Queue for WordPressAction Scheduler предоставляет WP-CLI команды для управления и просмотра очереди; CLI доступность и параметры зависят от установленной версии; Для мониторинга можно предпочесть официальный CLI прямому чтению внутренних таблиц
- PHP: Status Page - ManualPHP-FPM status page показывает pool, process и queue metrics; Поддерживаются JSON/OpenMetrics и другие форматы; Страница может раскрывать сведения о запросах и должна быть ограничена внутренними/доверенными адресами; Независимый status listener помогает получать статус при занятости основного pool
- PHP: Configuration - Manualpm.status_path и ping.path задаются в pool configuration; pm.max_children ограничивает число child processes; listen и listen.allowed_clients определяют endpoint и допустимых FastCGI clients
- MySQL :: MySQL 8.4 Reference Manual :: 7.1.10 Server Status VariablesMySQL exposes Threads_connected, Threads_running, Connections, Aborted_connects, Max_used_connections и Slow_queries; Многие status variables являются накопительными и требуют интерпретации как delta/rate; Набор и семантика сверяются с версией сервера
- MySQL :: MySQL 8.4 Reference Manual :: 29.12.11 Performance Schema Replication TablesPerformance Schema предоставляет таблицы состояния receiver, applier, coordinator и workers; Табличная форма лучше подходит для программного чтения, чем SHOW REPLICA STATUS; Multithreaded replication errors доступны per-worker
- INFO | DocsINFO возвращает секции server, clients, memory, stats, replication и keyspace; Поля включают used_memory, maxmemory, evicted_keys, keyspace_hits, keyspace_misses и blocked_clients; Ответ и доступные поля могут зависеть от версии
- PING | DocsPING проверяет способность сервера обслужить команду; PING не доказывает корректность WordPress object cache или пользовательского пути
- ACL | DocsRedis ACL ограничивает команды, keys/channels и аутентификацию пользователей; Monitoring user следует ограничивать необходимыми командами; ACL является частью защиты, но не заменяет TLS и сетевое ограничение
- 15 Dependent itemОдин master item может собирать набор метрик; Dependent items заполняются из master value через preprocessing; Dependent items не имеют отдельного update interval
- 4 JSONPath functionalityJSONPath используется в preprocessing для извлечения значений из JSON; Поддерживаются dot и bracket notation и функции; Выражения следует тестировать на фактической схеме ответа
- Low-level discoveryLLD создаёт items/triggers/graphs из discovery rows и prototypes; LLD macros могут извлекаться из JSONPath; Discovery оправдано для изменяемых множеств объектов
- 3 Trigger dependenciesTrigger dependency подавляет уведомления/действия зависимого symptom event при проблеме master trigger; Dependencies помогают уменьшать каскад событий; Причинный граф не должен создавать циклы
- 4 Secret user macrosZabbix поддерживает Secret text и Vault secret macros; Скрытие macro не предотвращает раскрытие через item/script output; Secret macros нельзя использовать в trigger expressions
- 2 Trigger expressionHistory functions reference an item key in /host/key form; The evaluation period is supplied to a history function such as min(); An unsupported referenced item can make trigger evaluation unknown
- 14 Calculated itemCalculated items derive stored values from existing item values; Calculated item formulas share syntax with trigger expressions and reference actual item keys; Numeric float results require Numeric (float) to avoid truncation
- History and trendsHistory хранит детальные значения, trends — почасовые агрегаты numeric values; Периоды хранения настраиваются; Сырые master payload и числовые dependent items требуют разных политик хранения
Евгений Семёнов · IT Fresh
Если самостоятельно не сможете — обращайтесь ко мне
Если вам не удаётся самостоятельно настроить или стабилизировать мониторинг WordPress и WooCommerce в Zabbix либо вы готовите перенос магазина, обращайтесь ко мне. Я помогу разобраться с причиной сбоев, а вместе с командой IT Fresh мы настроим контроль сайта, PHP-FPM, базы данных, Redis и фоновых очередей под вашу инфраструктуру. Напишите мне в Telegram @ITfresh_Boss, позвоните +7 903 729-62-41 или оставьте заявку на ITfresh.ru.