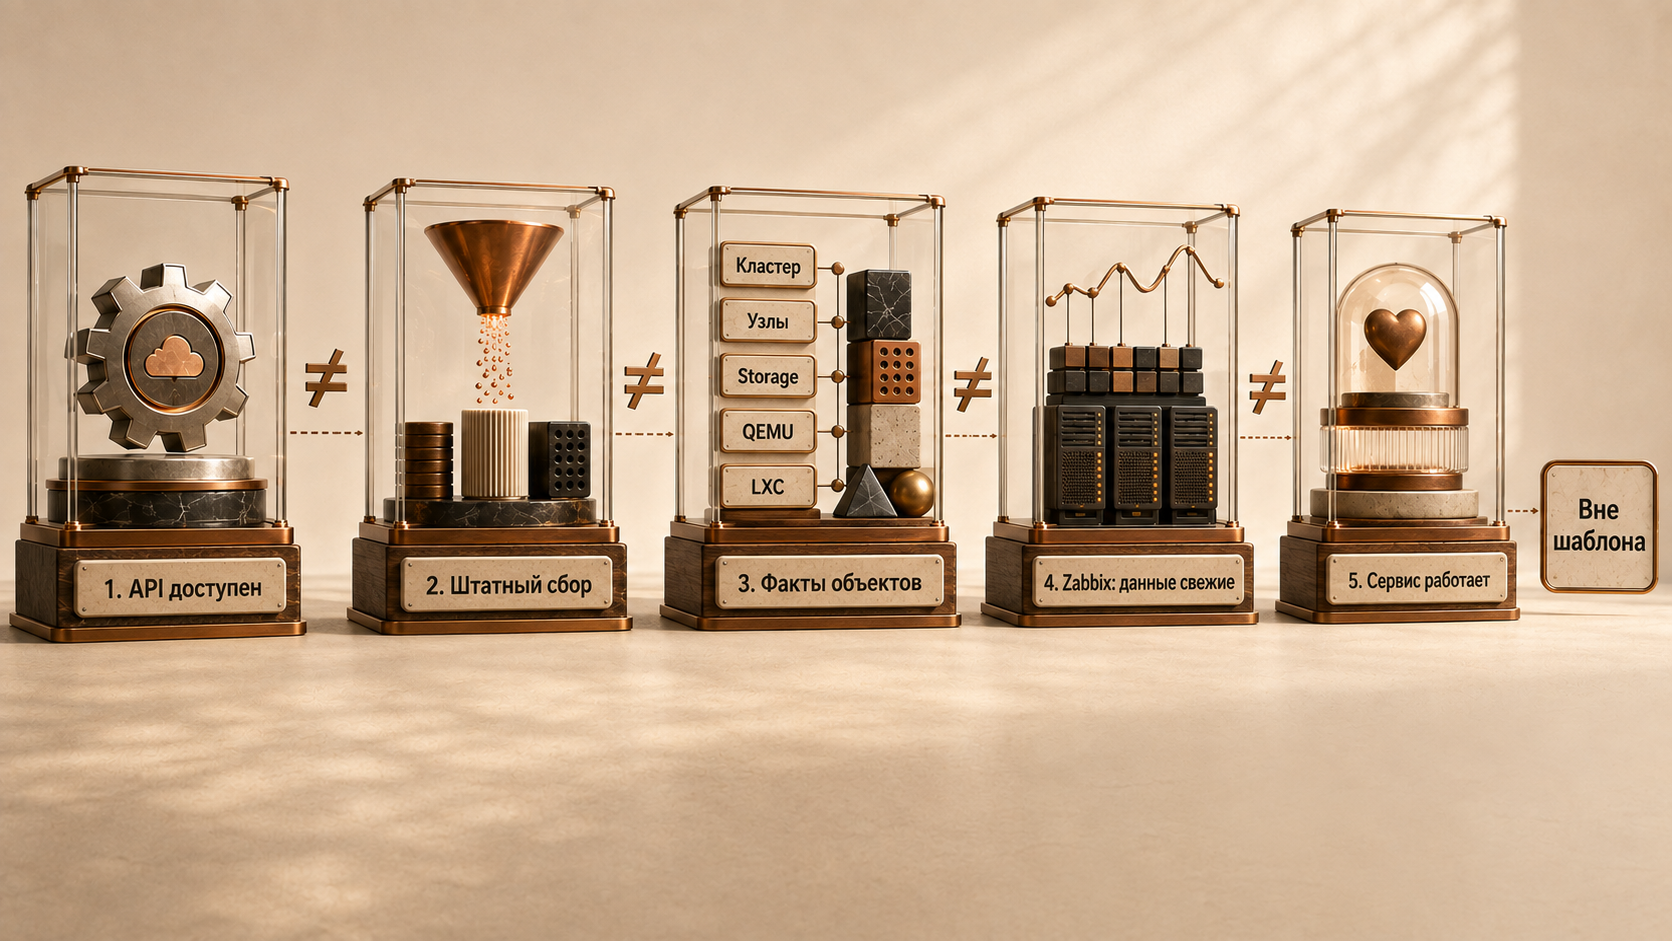
Доступность API, состояние объектов, здоровье сбора Zabbix и работа сервисов — разные свидетельства, которые нельзя заменять друг другом.
Границы материала
Я показываю порядок внедрения на обезличенных подстановках. Версии, права, доверие TLS, интервалы, пороги и безопасный сценарий проверки подтверждаю для каждой среды отдельно.
Фактическая основа статьи — официальный шаблон Proxmox VE by HTTP из ветки Zabbix release/7.4, экспорт version 7.4, vendor version 7.4-3, полученный 2026-09-04; страница интеграции указывает Zabbix 7.4+ и тестирование на Proxmox VE 8.4.0. Это не обещает совместимость с любым PVE build: перед внедрением я сверяю текущий YAML, release notes и ответы API конкретного кластера. Руководство Proxmox VE на дату проверки относится к актуальной линии 9.x, поэтому команды управления доступом сначала проверяются в документации установленной версии.
Я начинаю мониторинг Proxmox VE не с графика CPU, а с вопроса, какой именно слой подтверждает каждый сигнал. Официальный шаблон Proxmox VE by HTTP читает PVE API, видит кластерные ресурсы, quorum, узлы, QEMU-машины, LXC-контейнеры, хранилища и часть данных QEMU Guest Agent. Это хорошая карта гипервизора, но она не доказывает работоспособность приложения внутри гостя, свежесть резервной копии или здоровье Ceph во всей глубине.
В этой практике я опираюсь на фактический YAML ветки Zabbix release/7.4, а не на названия из старых версий или память. На дату проверки экспорт имеет версию 7.4 и vendor version 7.4-3; официальная страница интеграции требует Zabbix 7.4 или новее и называет протестированной Proxmox VE 8.4.0. При обновлении шаблон меняется, поэтому перед импортом я повторно сравниваю ветку, release notes и установленный PVE build.
Все имена, адреса и значения ниже — подстановки. Я не отключаю проверку TLS ради быстрого успеха, не выдаю токену административную роль и не устраиваю реальный отказ без согласованного окна. Сначала доказываю путь чтения, затем качество обнаружения, после этого — причинную связь событий и только в конце безопасно проверяю восстановление.
1. Фиксирую модель покрытия и границы доказательства
Для приёмки я разделяю пять слоёв наблюдения. Первый — доступность и аутентификация Proxmox API. Второй — подтверждённые штатным шаблоном метрики кластера, узлов, storage, QEMU и LXC. Третий — здоровье приёма и обработки этих данных на стороне Zabbix: master и dependent items, preprocessing, LLD и свежесть значений. Четвёртый — дополнительные платформенные проверки вне штатного шаблона. Пятый — отдельные гостевые бизнес- и сервисные проверки. Если первый или третий слой не работает, объектные значения могут просто устареть; это не доказательство одновременного отказа всех объектов. И наоборот, доступный API не доказывает здоровье кластера, VM или сервиса.
Официальный YAML действительно содержит кластерный master item proxmox_ve.cluster.resources.get, зависимые значения CPU, памяти, storage, числа работающих и остановленных QEMU/LXC, а также proxmox_ve.cluster.quorum.status. Он собирает данные узлов, пользователей, физических дисков и сертификатов, создаёт обнаруженные показатели и триггеры. Я использую это как базовый гипервизорный контур и не приписываю ему объектов, которых в экспорте нет.
Граница принципиальна: API сообщает то, что знает Proxmox. Состояние running у VM означает состояние виртуальной машины в управляющем слое, а не успешный вход пользователя, ответ базы или корректную бизнес-операцию. Поэтому для ОС и сервисов я связываю отдельный Linux/Windows Zabbix agent, HTTP-сценарий или прикладную проверку. Шаблон PVE остаётся источником инфраструктурного контекста, а не универсальным доказательством доступности сервиса.
2. Сверяю версию по матрице, а не по похожему названию
Моя матрица совместимости короткая и проверяемая: версия шаблона 7.4-3; требуется Zabbix 7.4 и выше; шаблон протестирован только на Proxmox VE 8.4.0. Это три разных факта. Последняя часть означает единственную подтверждённую точку тестирования, а не поддержку всех PVE 8.x, PVE 9.x или будущего API.
Для Zabbix 7.0 LTS я использовал бы ветку release/7.0, а не импортировал бы 7.4-экспорт вслепую. Это особенно важно сейчас: Zabbix 7.4 ввёл nested LLD, а рассмотренный YAML Proxmox 7.4 содержит parent_discovery_rule. Значит, перечень правил и поведение обнаружения в старой статье или UI другой версии нельзя механически переносить в текущую конфигурацию.
Перед внедрением я записываю четыре значения: версию Zabbix server, версию proxy, если он выполняет проверки, PVE manager build и SHA256 скачанного YAML. Затем импортирую шаблон в изолированном контуре и смотрю результат сравнения конфигурации. После minor-upgrade повторяю проверку template changes: совместимый API не означает неизменный набор item keys, фильтров, preprocessing или trigger prototypes.
3. Строю путь server или proxy → HTTPS API :8006 с нормальным TLS
Исполняющая сторона — Zabbix server либо назначенный хосту proxy. От неё должен открываться TCP-путь к https://<pve-api.example>:8006/api2/json/...; веб-браузер администратора здесь ничего не доказывает. pveproxy предоставляет API наружу, а в YAML порт по умолчанию задаёт {$PVE.URL.PORT}=8006. Я размещаю proxy ближе к закрытому управляющему сегменту, если это сокращает межсетевой доступ, но не публикую PVE API в Интернет ради мониторинга.
В 7.4-шаблоне {$HTTP.TLS.VERIFY} по умолчанию равно full. Именно JavaScript-выполнение Script master item отображает full в проверку peer и host, peer — только peer, none — ни peer, ни host; любое другое значение возвращает режим full. В полном YAML 27 сущностей типа HTTP agent: 2 обычных items, 7 discovery rules и 18 item prototypes. У всех отсутствуют поля verify_peer и verify_host; макрос {$HTTP.TLS.VERIFY} управляет Script items и не включает эти проверки для HTTP agent. Перед приёмкой я явно включаю SSL verify peer и SSL verify host для HTTP agent items, правил discovery и прототипов в локальной конфигурации, проверяю доверенную CA и соответствие имени сертификата из контекста выполняющего server/proxy. Значение full у макроса и отдельная успешная TLS-проба сами по себе не подтверждают проверку сертификата всеми запросами шаблона.
Я проверяю маршрут и TLS из контекста server/proxy, не помещая токен в командную строку или журнал. Сначала DNS и TCP, затем рукопожатие с явным SNI и CA, после — read-only API-запрос через защищённый временный механизм секретов. Если используется {$PVE.PROXY}, учитываю, что это HTTP proxy именно для запросов шаблона, а не Zabbix proxy. Эти два понятия нельзя смешивать при диагностике.
4. Создаю отдельную identity и privilege-separated token
Для примера с локальным realm я использую подстановки: pveum user add zabbix-monitor@pve --comment 'Zabbix read-only monitoring'; затем pveum user token add zabbix-monitor@pve zabbix --privsep 1. Команда создания показывает secret один раз — я сразу переношу его в утверждённое хранилище и не вставляю в тикет, shell history или статью. Реальный realm и правила жизненного цикла выбираются по политике организации.
Privilege separation нужно понимать буквально. По руководству Proxmox effective permissions отдельного токена вычисляются пересечением прав связанного пользователя и самого токена. Поэтому при --privsep 1 необходимые ACL должны быть предоставлены и backing user, и token identity. Как осторожный пример синтаксиса можно начать с широкой встроенной read-only роли: pveum acl modify / -user zabbix-monitor@pve -role PVEAuditor и pveum acl modify / -token 'zabbix-monitor@pve!zabbix' -role PVEAuditor. Здесь намеренно используется singular -token, как в текущем официальном примере; перед выполнением я сверяю pveum acl modify --help установленной версии.
README/YAML официального шаблона перечисляет ровно 23 требуемых API path и требует необходимые уровни доступа одновременно для пользователя и токена, но не задаёт точную роль или набор privileges. PVEAuditor — лишь широкая встроенная read-only отправная точка: документация не доказывает, что назначение этой роли на / достаточно для всех 23 вызовов, что оно endpoint-minimal или что это точный least privilege. До использования я проверяю help установленной версии, effective permissions backing user и токена, затем каждый из 23 read-only endpoint с этим токеном. При любом 403 сопоставляю точное недостающее право по API schema установленной версии, не выдаю Administrator и не изобретаю custom role или список privileges.
Отдельно фиксирую срок действия, владельца и процедуру отзыва. Monitoring identity не получает интерактивный административный сценарий и не переиспользуется автоматизацией управления VM. Если токен скомпрометирован, я создаю новый secret, меняю host macro через защищённый процесс, подтверждаю сбор, после чего отзываю старый токен. Это ротация учётных данных, а не повод временно повысить роль или отключить privilege separation.
5. Создаю один host, связываю официальный template и задаю точные макросы
В Zabbix я создаю host, назначаю ему server или proxy, затем связываю ровно Proxmox VE by HTTP. HTTP template не требует Zabbix agent interface для самих API items: адрес берётся из host macro. Основные обязательные значения из YAML — {$PVE.URL.HOST}, {$PVE.URL.PORT}, {$PVE.TOKEN.ID} и {$PVE.TOKEN.SECRET}. Макрос {$PVE.TOKEN.ID} должен содержать именно USER@REALM!TOKENID; официальный шаблон формирует точный заголовок Authorization: PVEAPIToken=USER@REALM!TOKENID=SECRET. Secret храню как Secret text; тип SECRET_TEXT сам по себе не доказывает шифрование at rest.
Сразу задаю {$HTTP.TLS.VERIFY} осознанно и при необходимости {$PVE.PROXY} для HTTP proxy. Остальные 7.4-макросы — не обязательные credentials, а фильтры, интервалы и пороги. Среди них есть фильтры node, QEMU, LXC, storage, disk, certificate, QEMU filesystem/network/OS, интервалы cluster/node/cert/disk/storage/user и контекстные пороги CPU, memory, disk, swap, uptime. Я не заменяю эти имена вариантами из 7.0.
После связывания я не жду только зелёного availability icon: открываю Latest data, очередь и unsupported items. Сначала должны появиться master items, затем dependent values и LLD results. Host-level macros имеют приоритет над template/global macros; это удобно для endpoint и секрета конкретного кластера. Секретный макрос маскируется и не экспортирует значение, но это не отменяет разграничения доступа к frontend и резервным копиям Zabbix.
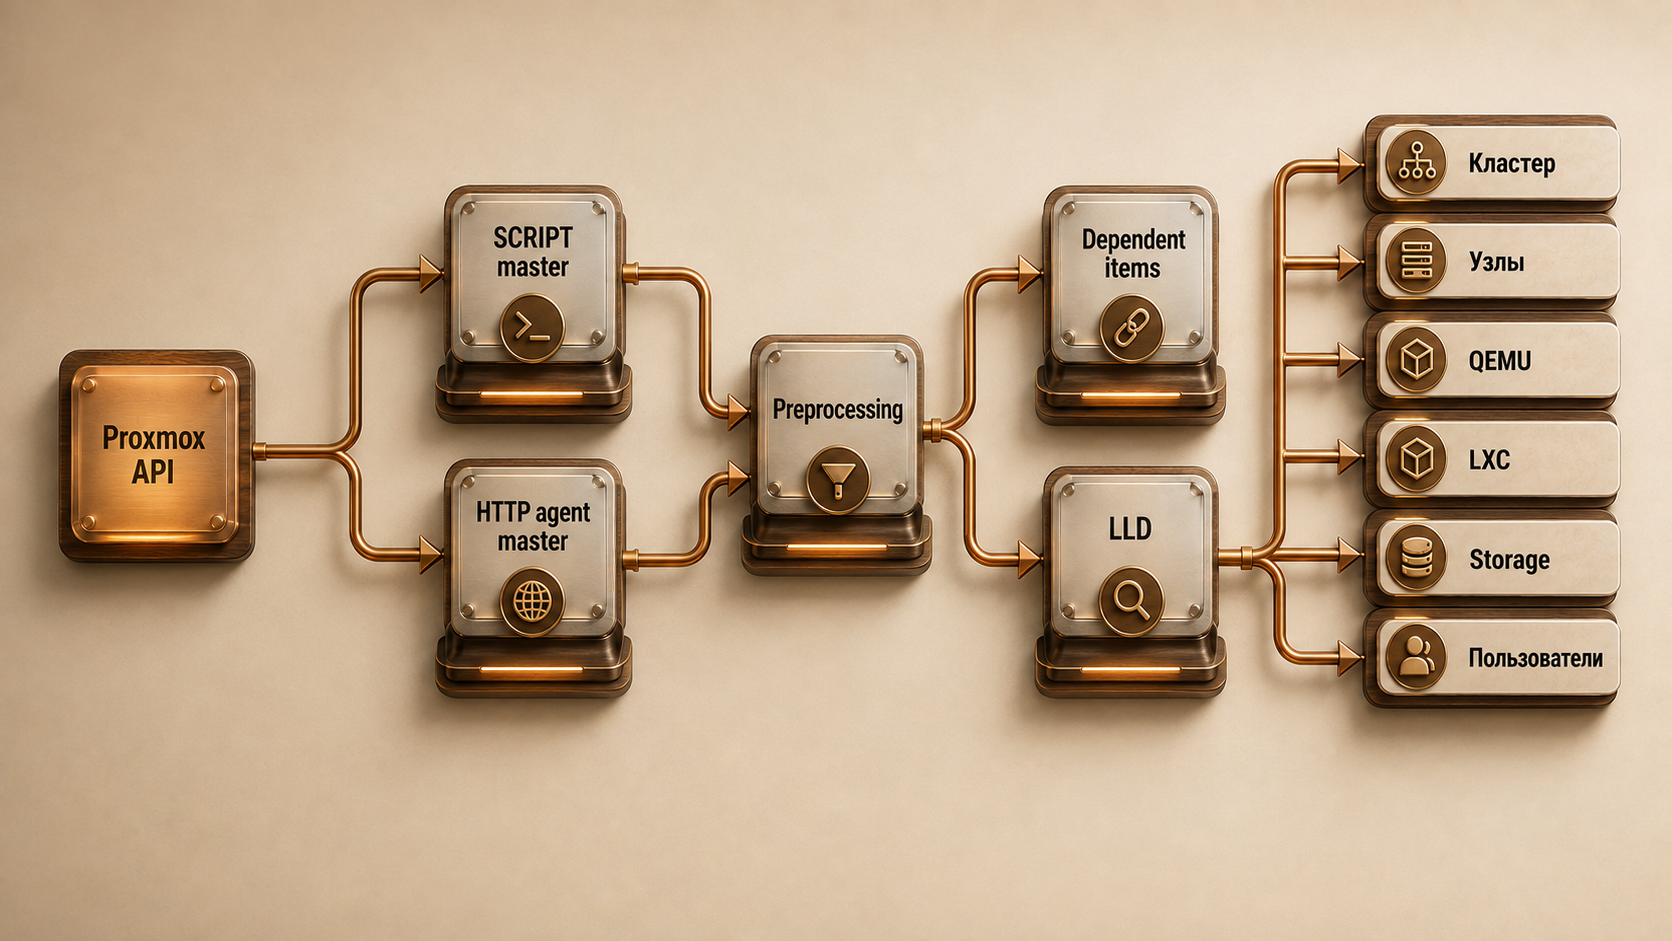
Штатный шаблон переиспользует ответы master items и раскрывает подтверждённые API-объекты через dependent items и LLD.
В 7.4 cluster сам по себе не обнаруживается отдельным LLD-правилом: его агрегаты являются обычными dependent items от proxmox_ve.cluster.resources.get. Корневое Proxmox nodes discovery зависит от proxmox_ve.get_node_data. Уже к узлу через parent_discovery_rule: proxmox_ve.nodes.discovery привязаны certificate discovery, disks discovery, LXC discovery, QEMU discovery и node storage discovery. Это и есть nested LLD в рассмотренном 7.4-шаблоне.
Внутри QEMU обнаруживаются filesystems, network interfaces, IP addresses и OS info; эти ветки используют PVE endpoints QEMU Guest Agent. Отдельно существуют Proxmox shared storage discovery и Proxmox users discovery. Сертификаты, следовательно, действительно обнаруживаются, но не как абстрактный кластерный список: правило ходит к /nodes/{#NODE.NAME}/certificates/info, а прототипы извлекают filename, fingerprint, issuer, subject, not-before и not-after.
LLD не создаёт отдельные hosts для узлов или VM: в правилах нет host prototypes. Оно создаёт items и triggers на том же Zabbix host шаблона. Я учитываю фильтры MATCH/NOTMATCH и статус QEMU/LXC, а также {$PVE.LLD.ENABLE.CERT}, DISK, STORAGE. Если объект отфильтрован или перестал обнаруживаться, это не равно физическому исчезновению: проверяю preprocessing, фильтр и правила disable/delete lost resources до вывода об аварии.
После первого discovery я сохраняю обезличенную таблицу ожиданий: число узлов, QEMU, LXC, shared и node storage, физических дисков и сертификатов. Она не является статической CMDB, но помогает заметить ошибку фильтра или неожиданное размножение prototypes. Для каждой ветви проверяю хотя бы один созданный item, его master, timestamp и источник поля. Простое совпадение общего количества недостаточно: два объекта могут поменяться местами, а счётчик останется прежним.
7. Использую master/dependent design и понимаю, где запросы всё же отдельные
Главная экономия API-запросов видна в proxmox_ve.cluster.resources.get: один Script item запрашивает cluster resources/status и формирует JSON, из которого dependent items через JSONPath получают CPU, memory, storage, counts и quorum. Те же данные питают dependent discovery QEMU/LXC/shared storage и отдельные поля. По документации Zabbix новое значение master автоматически заполняет dependent items; их interval не может отличаться от master.
Похожая схема работает для proxmox_ve.get_node_data и proxmox_ve.get_user_data, а внутри каждого QEMU/LXC/storage есть HTTP master Get info, от которого расходятся dependent metrics. Preprocessing включает JSONPath, JavaScript, multiplier, change per second и discard unchanged heartbeat. Это уменьшает повторное получение одного payload, синхронизирует связанные значения и переносит разбор на preprocessing manager server/proxy.
Но я не называю шаблон одним запросом на весь кластер. Certificate/disks/storage discovery, SMART, time/version/update, hardware и Guest Agent branches выполняют отдельные HTTP calls согласно YAML и своим интервалам. Поэтому нагрузку оцениваю по числу узлов, VM, интерфейсов, файловых систем и выбранным intervals. Интервал уменьшаю только после наблюдения за очередью Zabbix, временем ответа PVE и полезностью сигнала; низкая задержка не оправдывает опрос неизменного инвентаря каждую минуту.
Разбор master payload я рассматриваю как часть производительности мониторинга. Большой JSON экономит сетевые обращения, но создаёт работу preprocessing manager и множество history values. На proxy этот разбор выполняется там же, где мониторится host. Поэтому при расширении пилота я смотрю не только на нагрузку PVE, но и на preprocessing queue, busy workers, размер истории и частоту discard-unchanged. Если этот слой требует отдельного разбора queue, pollers, preprocessing или proxy, использую материал «Как я устраняю рост очереди Zabbix server и загрузку poller-процессов», не назначая очередь причиной каждой задержки Proxmox.
8. Выбираю полезные items и не выдумываю bundled dependencies
В качестве верхнего набора я вывожу Cluster: Quorum status, число online/offline nodes, cluster CPU/memory/storage utilization и counts running/stopped QEMU/LXC. На уровне узла полезны status, uptime, version, available updates, CPU/memory/disk utilization и время. Для storage — type, content, total, used, utilization; для QEMU/LXC — status, worked node, uptime, CPU, memory, disk и network rates. Физические disks дают inventory и SMART status, certificates — сроки и identity.
Сокращённые фрагменты ниже — семантические описания триггеров, а не их точные полные имена из YAML. Среди них: ошибка обновления cluster resources и изменение quorum; для узлов — offline-состояние, resource utilization, restart, смена версии и доступные обновления. Для QEMU/LXC описываются not running, restart, смена рабочего узла и предупреждения CPU/memory; для QEMU также — выключенный Agent и ошибка guest-agent data. Для storage и guest filesystem есть high-usage prototypes, для disk — SMART fail, для certificate — not valid. Для отдельного примера глубокой диагностики storage latency и калибровки порогов в другой платформе подходит статья «VMware vSphere: как разделить задержку datastore на read/write и kernel/device/command и откалибровать пороги Zabbix»; VMware counters я в Proxmox не переношу.
Bundled dependencies ограничены. QEMU: Error getting guest agent data зависит от Agent is not enabled; restart QEMU зависит от его Not running, restart LXC — от LXC Not running. В официальном YAML нет общей зависимости всех node/VM/storage events от API update error или quorum. Поэтому я не заявляю такую корреляцию встроенной. Если добавляю локальные dependencies, делаю это отдельным overlay с экспортом, обоснованием и тестом, чтобы обновление official template не затёрло решение молча.
9. Не смешиваю видимость гипервизора и мониторинг внутри гостя
PVE status running, uptime, allocated memory и I/O показывают взгляд гипервизора. Даже QEMU Guest Agent endpoints не заменяют Zabbix agent: официальный шаблон получает версию агента, время, timezone, filesystem, network и OS info, но не контролирует произвольную службу, журнал приложения, транзакцию базы или пользовательский маршрут. Для LXC в этом YAML нет аналогичного глубокого guest-agent дерева.
Я создаю отдельный Zabbix host для каждой критичной гостевой ОС, когда нужен агентный или прикладной контроль. Его связь с PVE inventory строю по стабильному внутреннему идентификатору и согласованному naming, не по случайному IP из discovery. Тогда событие VM Not running объясняет потерю agent availability, а работающий VM при упавшем приложении остаётся самостоятельной проблемой гостя.
Особенно осторожно обращаюсь с Guest Agent. Триггер Agent is not enabled говорит о конфигурации PVE/QEMU guest agent, а не об отказе Zabbix agent. Ошибка получения guest-agent data зависит от него в шаблоне, чтобы не плодить вторичный шум. Если guest agent намеренно не используется, применяю согласованный filter/override или severity policy; не подтверждаю массово постоянные проблемы и не называю их закрытыми.
10. Строю причинную карту и подавляю только доказанные симптомы
Моя причинная карта начинается с наблюдаемости. Ошибка master Cluster resources update error, HTTP 401/403, TLS или timeout означает проблему пути сбора; зависимые данные могут перестать обновляться. Следующая ветвь — quorum и node status. Ниже располагаются moved/not-running guests и storage. Ещё ниже — agent/app checks внутри VM. Такая последовательность помогает искать общий источник, но сама по себе не доказывает его.
Я добавляю зависимость только если родительское событие действительно делает дочерний сигнал неинформативным. Например, недоступность API может подавлять уведомления, созданные исключительно из протухшего API payload, но не должна скрывать независимый Zabbix agent внутри работающей VM. Потеря quorum не обязательно означает offline каждого узла, а storage utilization не объясняет SMART fail. Поэтому зависимости проверяю на парных сценариях и сохраняю history обоих событий.
Anti-noise состоит не только из dependencies. Сначала я назначаю владельца события, требуемое действие и проверяю доставку; затем как проектные решения использую context macros для согласованных исключений, устойчивое окно там, где оно технически оправдано, maintenance и разные маршруты по tags. Базовый YAML содержит конкретные dependencies только для guest-agent error и restart/not-running. Любая дополнительная причинность — моя локальная политика, которую нельзя выдавать за свойство официального template. Полную работу с dependencies, routing и очисткой alert pipeline оставляю материалу «Как я снижаю шум в оповещениях Zabbix, не пряча настоящую аварию»; здесь важна граница collector/API problem и object problem.
11. Настраиваю baseline и capacity без универсальных процентов
YAML поставляется с {$PVE.TRIGGER.CPU.WARNING}, DISK.WARNING, MEMORY.WARNING и SWAP.WARNING со значением 90, а {$PVE.TRIGGER.UPTIME} — 15m. Я воспринимаю их как defaults шаблона, а не как универсальную инженерную истину. Длительная CPU saturation, memory pressure, thin provisioning и заполнение backup storage имеют разную динамику; одинаковый процент не выражает одинаковый риск.
Сначала собираю репрезентативную историю: рабочие часы, резервное копирование, maintenance, миграции и сезонные пики. Для cluster, каждого node и storage смотрю уровень, тренд, доступный запас и скорость изменения. Порог задаю через macro context для конкретного объекта, когда его ёмкость или назначение отличаются. Критерий должен оставлять время на действие с учётом фактического роста и процедуры расширения, а не просто красиво делить шкалу.
Capacity review связываю с inventory: какие guests живут на storage, shared оно или node-local, какие stopped VM плановые, хватает ли ресурсов пережить согласованный сценарий недоступности узла. Официальный template даёт полезные totals/used/utilization и counts, но не рассчитывает организационный резерв N+1 и не знает бизнес-приоритет. Этот расчёт я документирую отдельно и не превращаю прогноз в гарантированный срок исчерпания.
Порог проверяю обратным вопросом: какое безопасное действие должен успеть выполнить дежурный после события? Если ответ — лишь «посмотреть график», критерий ещё не готов. Я записываю окно оценки, исключения для scheduled workload, владельца capacity и подтверждающий сигнал. После изменения нагрузки или состава кластера baseline начинаю заново; старая сезонность не должна автоматически оправдывать новую деградацию.
12. Проверяю отказ и восстановление без вреда production
Предпочтительный первый тест вообще не выключает узел: на согласованном тестовом объекте я кратко меняю только безопасно управляемый слой наблюдения — например, применяю к отдельному lab-host заведомо неверный token ID или блокирую API-доступ только от тестового Zabbix proxy. До шага фиксирую working latest values, время master item, quorum и отсутствие реальной кластерной аварии. Цель — увидеть ошибку сбора и затем полное возвращение данных после отката.
Проверку Not running выполняю только на заранее выделенной некритичной VM/LXC, для которой владелец подтвердил допустимую остановку и запуск штатными средствами. Потерю production quorum я не симулирую. Если требуется проверка node-offline или HA, это отдельное утверждённое учение с владельцем PVE, проверенной ёмкостью, fencing и планом возврата; одна статья не делает такой эксперимент безопасным.
Abort criteria: любое неожиданное изменение quorum, рост ошибок storage, затрагивание нецелевого гостя, потеря независимого канала управления, непредвиденное HA-действие или отсутствие согласованного наблюдателя. Тогда прекращаю сценарий, возвращаю ACL/firewall/token macro либо запускаю только целевой test guest по заранее записанному rollback. Успех — не один recovery event: master снова supported, timestamp обновляется, dependent/LLD values приходят, проблема закрывается ожидаемо, соседние checks не ухудшились, а ручной read-only снимок совпадает с Zabbix.
13. Разбираю 401, 403, TLS, proxy, timeout, unsupported и discovery
IT Fresh
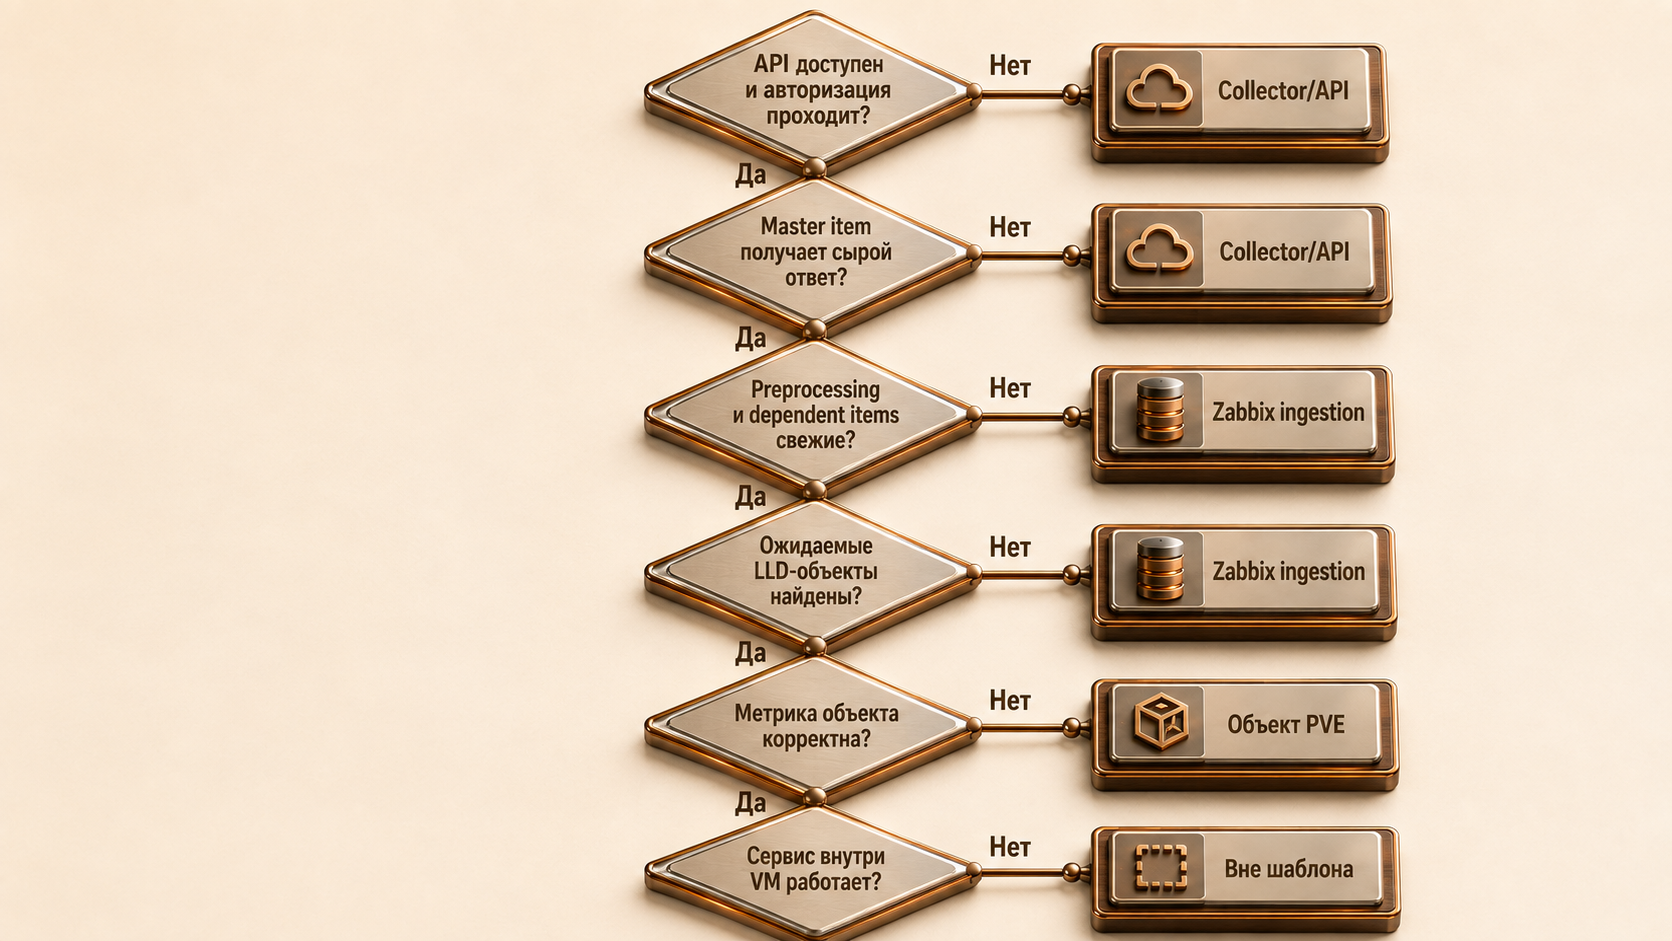
Приёмка идёт от тракта API к обработке в Zabbix и только затем к состоянию объекта и отдельной проверке сервиса.
При 401 сначала сверяю, что {$PVE.TOKEN.ID} содержит USER@REALM!TOKENID, а также secret, срок/статус пользователя и токена, отсутствие лишних пробелов и точный заголовок Authorization: PVEAPIToken=USER@REALM!TOKENID=SECRET, который строит YAML. При 403 проверяю ACL отдельно для backing user и privilege-separated token, effective permissions и каждый из 23 endpoint из README; точное недостающее privilege определяю по API schema установленной версии. Расширять роль до Administrator нельзя: это скрывает причину 403.
TLS error разбираю по цепочке, сроку, SAN и имени {$PVE.URL.HOST} из контекста выполняющего server/proxy. none допустимо только как краткая изолированная диагностика с немедленным возвратом; результат не считается готовой конфигурацией. При timeout смотрю DNS, firewall, маршрут, HTTP proxy {$PVE.PROXY}, время ответа PVE и item timeout. Отличаю Zabbix proxy, который исполняет item, от forward HTTP proxy в macro.
Unsupported item читаю вместе с preprocessing error: изменение JSON, пустой массив, недоступный Guest Agent или неожиданный status code требуют разных действий. Если нет discovery, проверяю parent node LLD, filters MATCH/NOTMATCH, status match, enable-macros и сырой JSON через штатный test preprocessing без публикации payload. После upgrade сверяю template branch и изменения nested LLD. API Viewer помогает подтвердить path/schema конкретной PVE-версии, но реальный ответ проверяю только read-only token и без вывода чувствительных полей.
14. Отдельно закрываю то, чего официальный template не обещает
IT Fresh
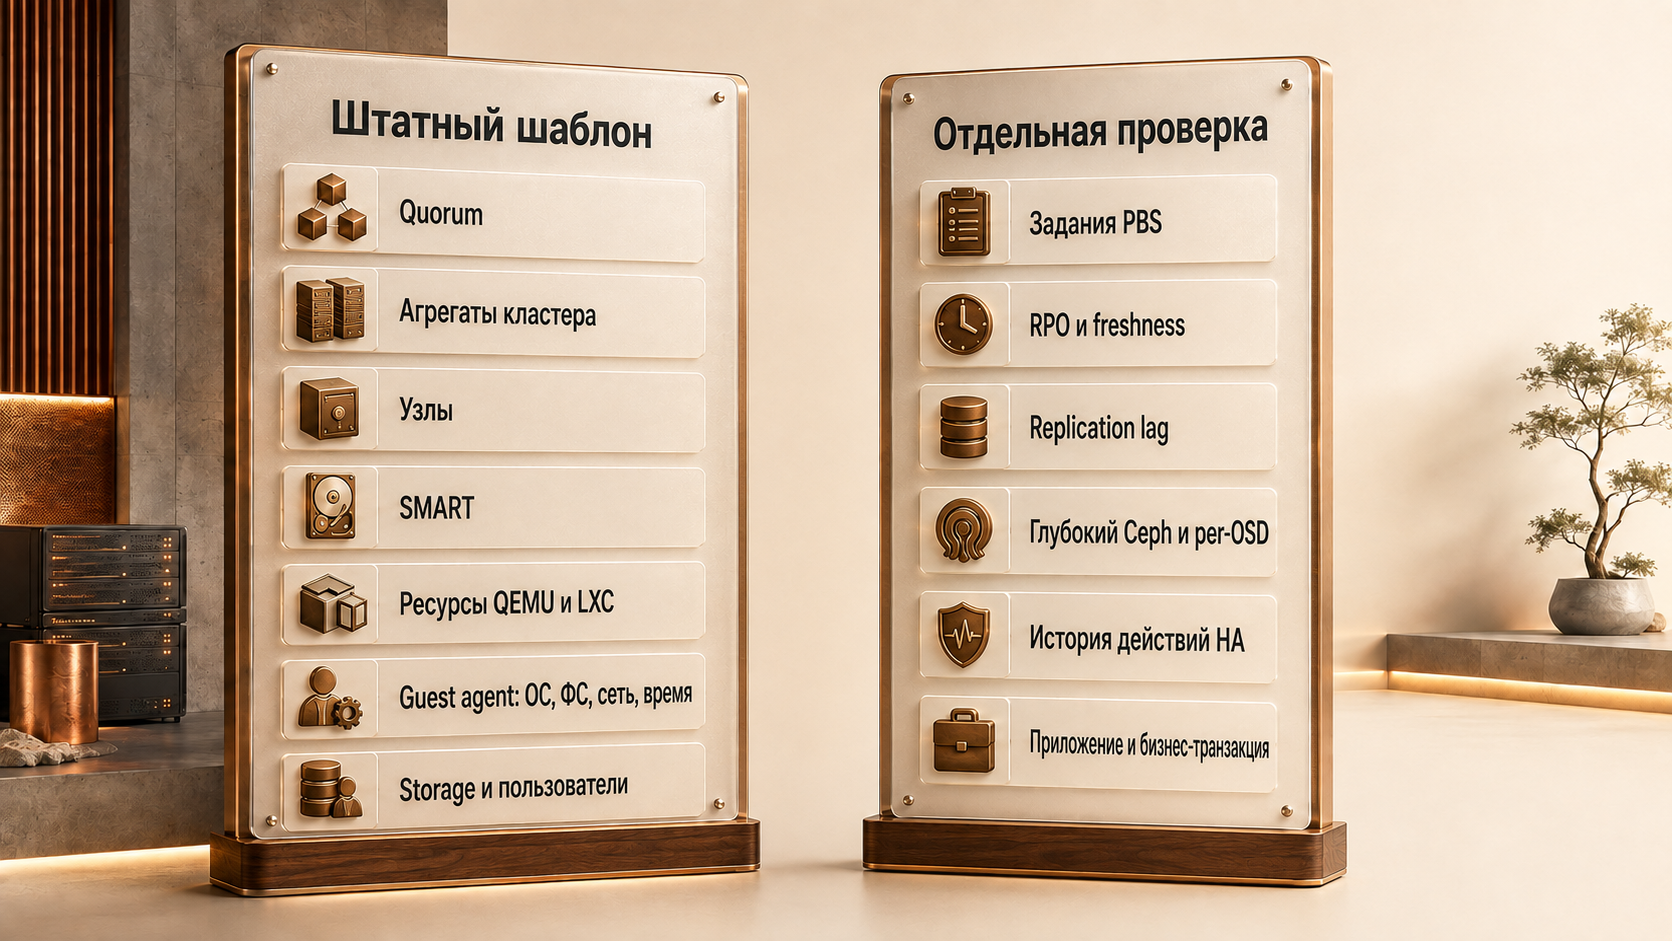
Storage, SMART, quorum и guest-agent telemetry полезны, но не заменяют PBS/RPO, глубокий Ceph/HA-контроль и бизнес-проверки.
PBS backup RPO официальным YAML не измеряется: в keys и API paths нет Proxmox Backup Server, backup job, snapshot age или последней успешной точки восстановления. Рядом видна лишь ёмкость storage и его content/type — этого недостаточно для RPO и restore verification. Для PBS я проектирую отдельный официальный API/job-check контур и проверку восстановления, не вывожу свежесть backup из свободного места.
Replication lag также отсутствует: шаблон не обращается к replication endpoints и не создаёт items по последнему sync/error. HA представлен лишь косвенно через status/changed worked node и общий ресурсный контекст; истории HA actions, CRM/LRM decisions и fencing timeline в YAML нет. Deep Ceph health тоже не покрыт: storage может иметь type rbd или cephfs и utilization, но MON quorum, OSD, PG, recovery/backfill и health detail не обнаруживаются.
Наконец, нет business checks внутри guests. QEMU Guest Agent даёт adjacent inventory и технические filesystem/network/OS/time данные, но не бизнес-транзакцию. Эти ограничения важны и для защиты от семантического дубля: данная статья — про штатный PVE API template, а опубликованный материал «Как я контролирую Ceph scrub и deep-scrub: просрочку проверок и ошибки целостности» отвечает за целостность Ceph. Я связываю отдельные контуры по tags/services, сохраняя разные источники истины и критерии восстановления.
15. Провожу rollout по чек-листу и оставляю обратимый rollback
До rollout я фиксирую версии Zabbix/PVE, SHA256 YAML, endpoint inventory, согласованный read-only доступ и владельцев. Проверяю DNS/TCP/TLS от server/proxy, создаю отдельные user/token с privilege separation, сохраняю secret только в защищённый канал, связываю официальный template с одним пилотным host и задаю точные host macros. Затем подтверждаю master items, quorum, node LLD, nested QEMU/LXC/storage/certificate branches и отсутствие необъяснённых unsupported items.
На пилоте сравниваю Zabbix с ручным read-only API-снимком, настраиваю filters и context thresholds, добавляю только доказанные локальные dependencies, проверяю маршрутизацию и recovery. После этого расширяю охват по одному кластеру, отслеживая API latency, Zabbix queue и preprocessing. Контролируемую проверку выполняю сначала на пути сбора, потом на некритичном guest; production quorum, HA и storage не трогаю в рамках обычной приёмки template.
Rollback состоит из отвязки template с сохранением собранных данных там, где это соответствует политике, возврата host macros/filters из экспорта, снятия только созданных ACL token/user и отмены тестового firewall rule. Перед удалением token убеждаюсь, что он не используется другим approved consumer. После возврата подтверждаю отсутствие запросов и лишних alerts. Экспорт local overlay храню отдельно от official template, чтобы обновление и откат были сравнимы.
Приёмочный протокол закрываю только после двух последовательных штатных циклов каждого проверяемого master и его зависимых значений. Для редких inventory rules учитываю их собственный interval и не ускоряю весь шаблон ради формальной галочки. В протокол попадают время проверки, версия template, список осознанных исключений, неподдерживаемые функции и ответственный за следующий пересмотр. Если часть endpoint недоступна из-за утверждённой модели прав, я отмечаю её как ограничение покрытия, а не маскирую ошибку preprocessing. Такой rollout оставляет понятный ответ на три вопроса: что мы видим, чего не видим и как безопасно вернуться к исходному состоянию.
Достаточно ли роли PVEAuditor для штатного шаблона?
Официальные инструкции этого не доказывают. Они перечисляют 23 API path для пользователя и токена, поэтому достаточность effective permissions я проверяю по каждому path без выдачи Administrator.
LLD обнаруживает узлы, их сертификаты и диски, QEMU, LXC и node storage; внутри QEMU — filesystems, interfaces, IP addresses и OS info. Отдельные правила обнаруживают shared storage и пользователей; сам cluster представлен dependent items, а не отдельным LLD-правилом.
Почему доступный API ещё не означает, что VM и сервисы исправны?
API подтверждает только доступ к управляющему слою. Состояние VM в Proxmox, работа гостевой ОС и ответ приложения — разные свидетельства, поэтому критичные сервисы требуют отдельных проверок.
Как отличить проблему Proxmox от ошибки сбора или preprocessing в Zabbix?
Я иду по цепочке: доступ и authentication API, raw/master item, preprocessing и freshness dependent items, ожидаемые LLD-объекты, затем объектная метрика и отдельная гостевая проверка. Ошибка в начале цепочки не доказывает отказ всех объектов.
Proxmox monitoring and integration with Zabbix — Proxmox VE by HTTPОфициальное имя решения — Proxmox VE by HTTP; текущая страница указывает Zabbix 7.4 и requirement 7.4+.; В tested versions указан Proxmox VE 8.4.0.; Setup требует отдельного monitoring user/token, host macros {$PVE.TOKEN.ID}, {$PVE.TOKEN.SECRET}, {$PVE.URL.HOST}, при необходимости {$PVE.URL.PORT}; default port 8006.; Страница перечисляет необходимые API paths для cluster resources/status, access users, nodes, certificates, disks, QEMU/LXC, storage, time и version.; Macro {$HTTP.TLS.VERIFY} по умолчанию full; peer и none имеют описанные режимы проверки.
template_app_proxmox.yaml — Proxmox VE by HTTPПолный точный набор из 47 template macros, включая URL/token, {$PVE.PROXY}, {$HTTP.TLS.VERIFY}, LLD filters, intervals и trigger thresholds.; Master item proxmox_ve.cluster.resources.get и dependent cluster items: cpu, memory, storage, node/QEMU/LXC counts и proxmox_ve.cluster.quorum.status.; Master items proxmox_ve.get_node_data и proxmox_ve.get_user_data; HTTP master items и dependent item prototypes с JSONPath/JavaScript/multiplier/change-per-second/discard-unchanged-heartbeat.; LLD keys: proxmox_ve.nodes.discovery; nested certificate, disk, LXC, QEMU and node storage discoveries; nested QEMU filesystem, network, IP and OS discoveries; shared storage and users discoveries.; Rule prototypes have no host_prototypes; cluster metrics are direct/dependent items rather than a cluster discovery rule.; Actual triggers include Cluster resources update error, Cluster quorum status changed, node not online/resource/restart/version/update, QEMU/LXC state/resource/move/restart, Guest Agent, SMART, certificate and storage/filesystem usage signals.; Bundled dependencies found: QEMU guest-agent data error depends on Agent is not enabled; QEMU and LXC restart triggers depend on corresponding Not running triggers.; No keys/paths/prototypes for PBS backup RPO, backup freshness/restore, replication lag, Ceph MON/OSD/PG/health detail, HA action history or guest business transactions; adjacent storage type/capacity, worked-node and QEMU Guest Agent technical data do exist.
Zabbix 7.4 Proxmox template instructionsREADME перечисляет ровно 23 API path и требует необходимые уровни доступа для backing user и token.; README не задаёт точную роль или набор privileges и не доказывает достаточность PVEAuditor.
HTTP agentHTTP agent performs HTTP/HTTPS requests by Zabbix server or proxy without an agent on the monitored endpoint.; HTTP proxy, timeout, accepted status codes and SSL verify peer/host are configurable item properties.; Failure classes include transport, HTTP status, TLS and timeout behavior.
Dependent itemOne master item can collect multiple metrics in one query; a new master value populates dependent items.; Dependent values are extracted with preprocessing and cannot have an update interval different from the master.; Server or proxy performs preprocessing depending on where the host is monitored.
Item value preprocessingPreprocessing supports ordered transformations including JSONPath, JavaScript, multipliers, change per second and discard unchanged heartbeat.; Preprocessing can be tested and its failures must be distinguished from source transport failures.
Low-level discoveryLLD consumes JSON entities and prototypes to create items/triggers/graphs and supports nested discovery rules.; Filters and overrides control discovered objects; lost resources can be disabled and later deleted according to configured lifetimes.; Absence of a discovered object can result from filter/preprocessing/lost-resource behavior rather than physical failure.
Zabbix item intervalsUpdate intervals determine when master items collect new values.; Polling delay and discard-unchanged heartbeat have distinct semantics.
User macrosHost macros take precedence over linked template and global macros.; Macro value types include Text, Secret text and Vault secret; secret values are masked and are not exported.; User macro contexts support per-object threshold/filter customization.
Proxmox storageStorage is a distinct Proxmox subsystem beyond generic capacity and type values.; Generic storage fields do not establish PBS RPO, backup freshness or deep Ceph health.
pveum(1) — Proxmox VE User ManagerSyntax and semantics of pveum user add, user token add, acl modify, user permissions and user token permissions.; API token creation supports privilege separation; ACL identities can be users or tokens.; PVEAuditor is the built-in read-only/audit role.
Proxmox VE Administration GuideAPI tokens support stateless API authentication and their secrets are shown at creation time.; With privilege separation, token permissions are a subset/intersection of corresponding user permissions; monitoring example assigns ACL to both user scope and token.; Proxmox clusters use quorum/majority; loss of quorum prevents ordinary state-changing operations and is not a safe routine production test.; Storage, replication, HA and backup are separate operational subsystems with distinct state and recovery considerations.
Proxmox HAHA state and action history are a distinct operational subsystem.; Node status and worked-node values do not establish HA action-history coverage.
Proxmox VE API ViewerOfficial generated API schema is the reference for endpoint paths, methods and parameters of the installed/current API line.; The template paths can be checked against cluster, nodes, QEMU/LXC, storage, certificate and user endpoints.
Proxmox clusterCluster quorum and replication are distinct operational concepts.; Quorum and node status do not establish replication-lag coverage.
Если самостоятельно не сможете — обращайтесь ко мне
Я обсужу с вами версии, границы штатного покрытия, права и безопасную приёмку. Без обещания универсального результата: решение зависит от вашей версии и модели доступа.