Числа в настройках и расчётах — примеры для адаптации по собственным наблюдениям. Стендовый прогон не выполнялся.
Linux, rootful Docker Engine; профиль для репетиции Engine 28.x / Compose plugin 2.39.x, Bash, GNU coreutils, jq; один сервис web с одной репликой и json-file. Patch-версии и фактическая совместимость требуют стендовой проверки. Desktop, rootless, Swarm, Kubernetes, journald вне командного сценария.
Когда на Docker-хосте заканчивается место, я сначала определяю, какие данные растут и кто ими управляет. Удаление первых попавшихся файлов может временно улучшить график свободного пространства, но оставить приложение без доказательств ошибки или без нужных данных. Для журналов контейнеров мне нужен другой результат: понятный источник роста, ограниченный бюджет хранения и проверенный способ применить настройки к работающему сервису.
На Linux-хосте с Docker Engine и Compose я последовательно связываю рост диска с источником сообщений, задаю бюджет хранения и проверяю применение ротации после пересоздания контейнера. Числа в настройках и расчётах служат примерами: лимиты нужно подобрать по собственным наблюдениям за потоком логов, доступным местом и нужной глубиной истории.
IT Fresh
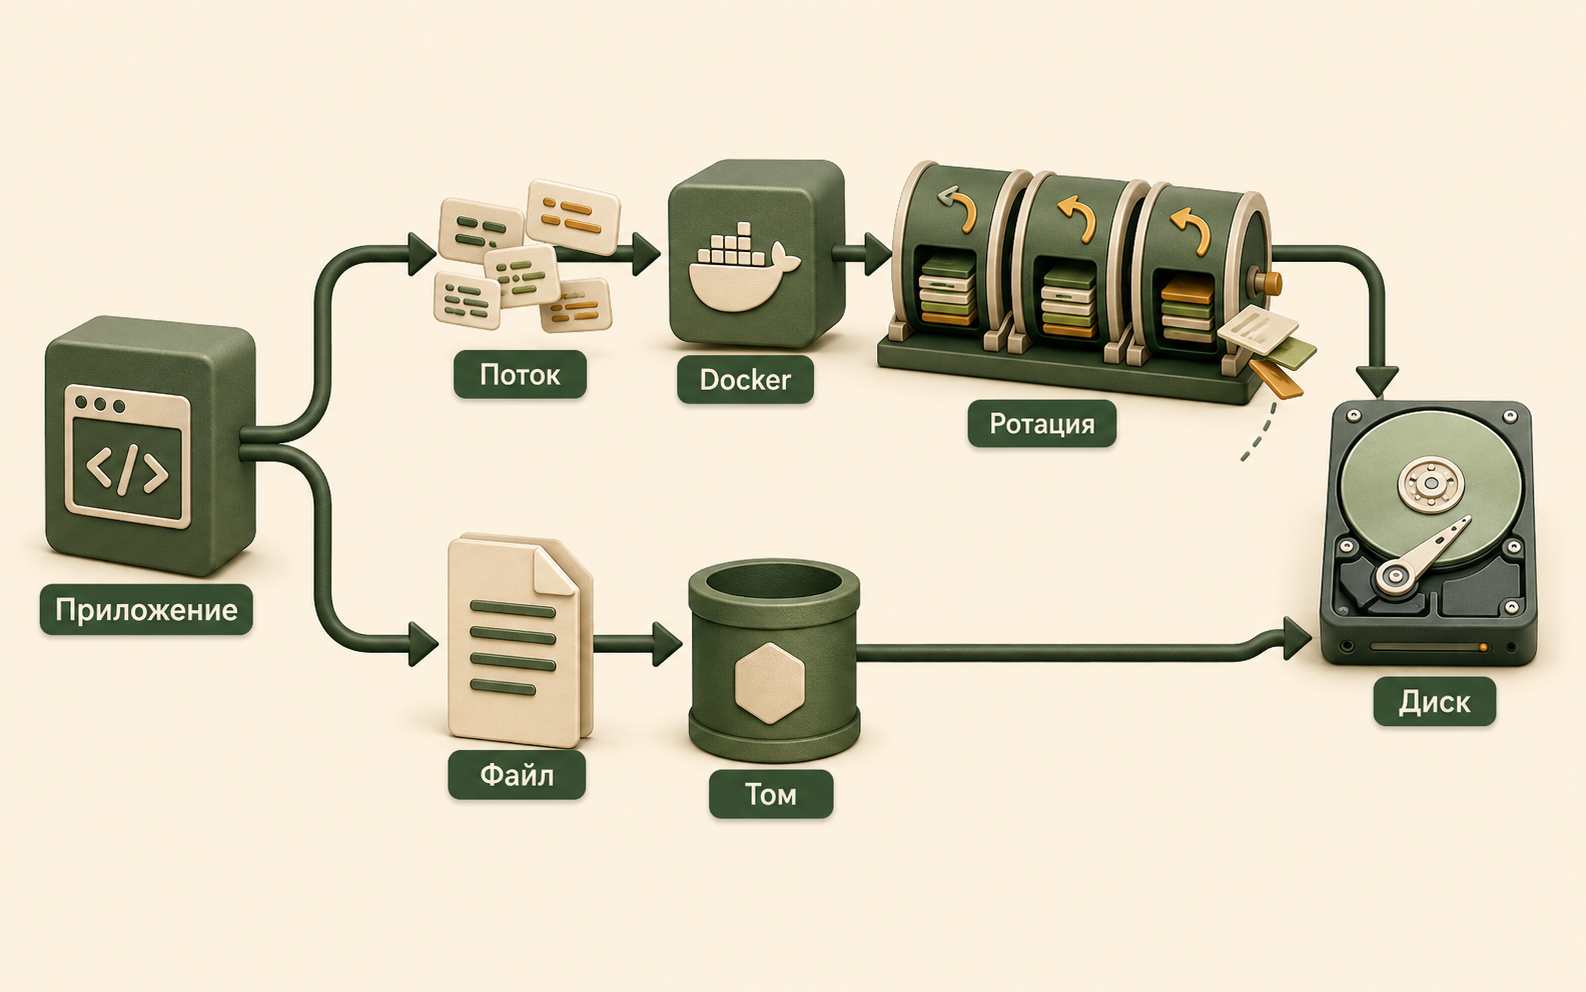
Лимит logging driver относится к потоку контейнера. Файловый журнал приложения требует собственного управления хранением.
1. Фиксирую границы среды и условия остановки
Примеры рассчитаны на обычный Linux-сервер, rootful Docker Engine, Compose plugin v2, Bash, GNU coreutils и установленный jq. Для предварительной репетиции я выбираю ветку Engine 28.x и Compose 2.39.x как явный профиль совместимости, а не утверждение о последних или рекомендуемых для обновления версиях. Точные patch-версии читатель фиксирует у себя; стендового запуска этих команд при подготовке статьи не было. Использованные страницы Docker прочитаны по HTTPS в ходе подготовки; время проверки приведено в журнале источников.
Основной сценарий — один Compose-сервис web с одной репликой и журналированием через json-file. Это учебное имя. Перед использованием команд я заменяю его реальным сервисом, перехожу в каталог действующего проекта и воспроизвожу его обычные параметры -p, все -f, профиль и файл окружения. Во всём примере показан простой проект с единственным compose.yaml. Для Docker Desktop, rootless, Swarm, Kubernetes и драйвера journald этот порядок нельзя переносить механически.
Я заранее определяю владельца приложения, допустимый перерыв и проверяемое пользовательское действие. Пересоздание единственной реплики означает потенциальный простой. Если сервис нельзя остановить, сначала нужен отдельный сценарий переключения трафика и проверки резервного экземпляра. Если неизвестно, где лежат постоянные данные, не подтверждена резервная копия или не хватает места даже для служебной записи, переход к изменению контейнера останавливается. Эта граница полезнее универсальной команды «починить Docker».
2. Отделяю полномочия администратора от прав мониторинга
Команды Docker ниже выполняет уполномоченный администратор в своей штатной сессии доступа. Отсутствие sudo перед каждой строкой не означает, что Docker API безопасен для непривилегированного наблюдателя. Группа docker предоставляет полномочия уровня root; я не добавляю туда пользователя Zabbix ради просмотра параметров логирования. Это свойство доступа прямо отмечено в официальной инструкции Docker по Linux.
Для постоянного контроля я разделяю задачи: агент получает метрики файловой системы обычным способом, а отдельный административный сборщик при необходимости публикует только разрешённые агрегаты. Например, имя сервиса из заранее заданного списка, тип драйвера, наличие лимита и время успешного сбора. Такой сборщик должен принадлежать администратору, иметь неизменяемый для агента путь и не принимать произвольные аргументы командной строки. Это проектное требование к реализации, готовый привилегированный скрипт здесь не предлагается.
Полный docker inspect может показать переменные окружения и другую конфигурацию, которую нельзя переносить в тикет. Поэтому я вывожу конкретные поля, не использую выгрузку окружения как доказательство и не прикладываю необработанные логи к публичному обсуждению. Даже названия внутренних каталогов иногда требуют обезличивания. Для диагностики роста важны время, размер, контейнер и тип повторяющегося сообщения; содержимое запросов пользователей обычно для этого не требуется.
3. Проверяю файловую систему, а не только список образов
Сначала я удостоверяюсь, что клиент подключён к нужному daemon. Команды df ниже относятся к файловой системе того хоста, на котором работает Engine. Если Docker context удалённый, локальный df не описывает его диск: продолжать нужно в административной сессии на целевом сервере. Путь хранения я беру из фактического Docker Root Dir, не предполагая обязательный /var/lib/docker.
docker context show
docker version --format 'client={{.Client.Version}} server={{.Server.Version}}'
docker compose version
docker info --format 'root={{.DockerRootDir}} default-log={{.LoggingDriver}}'
docker_root_dir=$(docker info --format '{{.DockerRootDir}}')
df -h -- "$docker_root_dir"
df -i -- "$docker_root_dir"
docker system df -v
Здесь мне нужны два независимых ответа: есть ли доступные блоки и есть ли свободные inode. Затем я сопоставляю состояние файловой системы с перечнем объектов Docker. docker system df -v показывает подробности использования диска объектами daemon. Документация этой команды не обещает отдельную исчерпывающую инвентаризацию файлов журналирования, поэтому её вывод я не превращаю в доказательство отсутствия больших логов. Назначение команды описано в Docker system df.
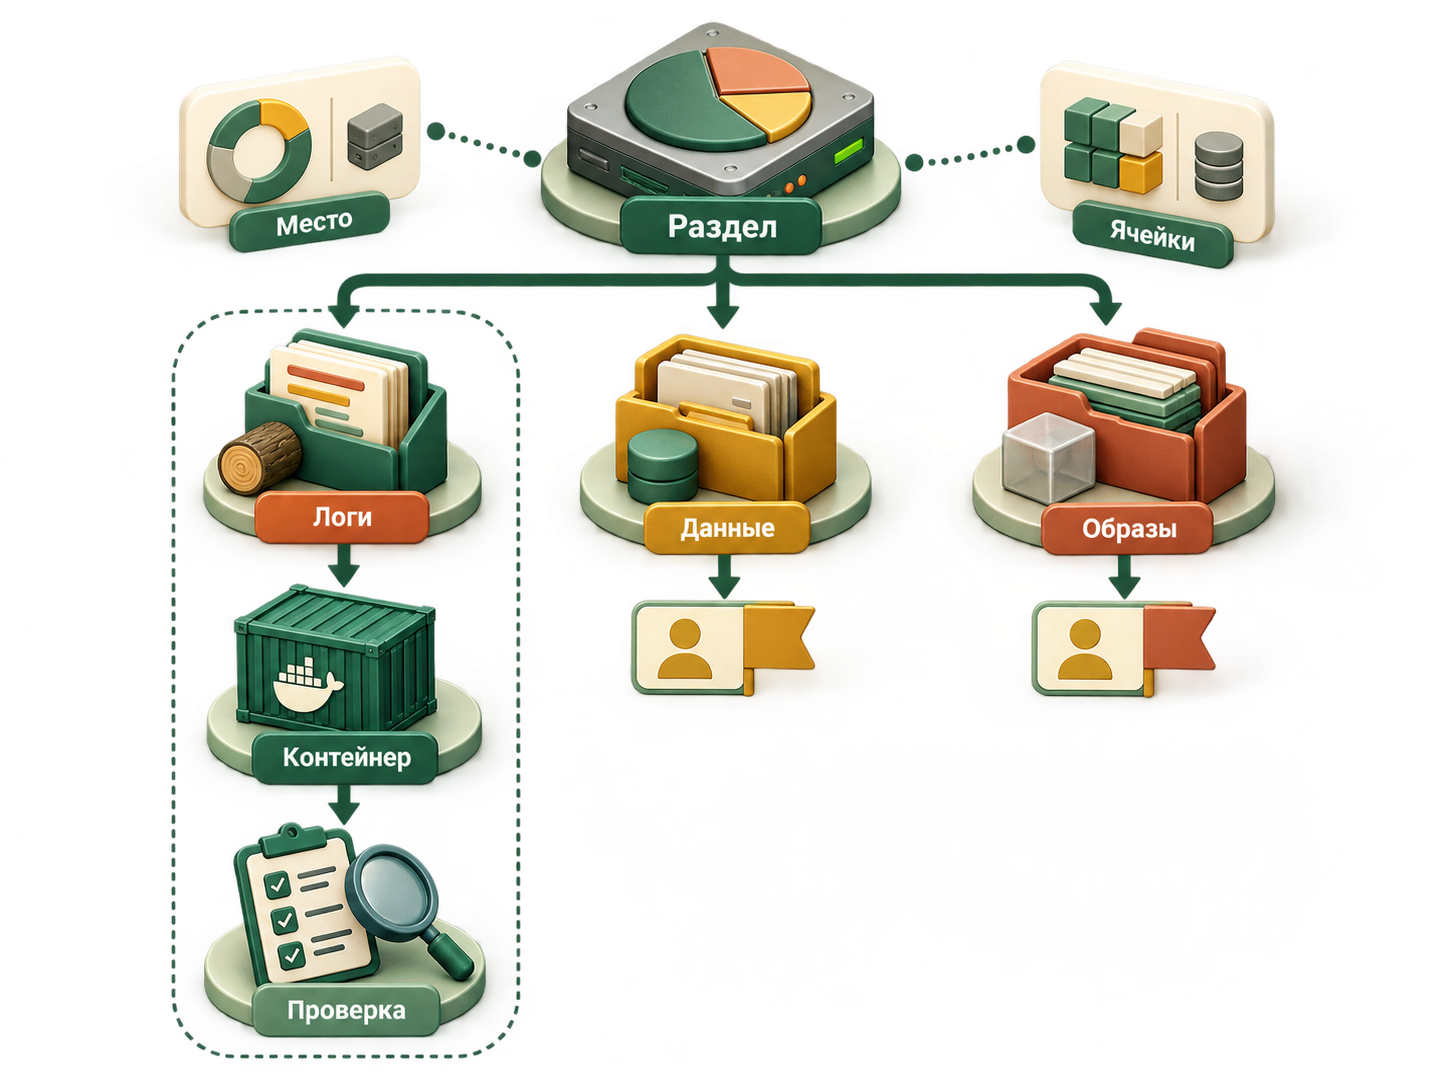
Для следующего шага я использую имеющийся мониторинг каталогов либо разовый административный учёт занятых блоков на нужном разделе. Рекурсивный обход всего сервера на перегруженном диске не запускаю. Мне достаточно локализовать рост: хранилище контейнерных журналов, bind mount приложения, именованный том, системный журнал или область образов. Файлы данных самого драйвера я не открываю сторонним редактором и не пытаюсь ротировать вручную.
Если рост оказался в каталоге базы данных или файловом логе внутри тома, настройка logging в Compose не является исправлением. Я передаю задачу в соответствующую процедуру хранения приложения. Если выводы противоречат друг другу, сохраняю статус «причина не установлена»: большой каталог Docker сам по себе ещё не доказывает вину stdout конкретного контейнера.
Сначала проверяю раздел и тип растущих данных. Только подтверждённая ветвь логов ведёт к изменению logging-политики.
4. Связываю источник сообщений с конкретным контейнером
После локализации я выбираю один сервис и фиксирую его идентификатор. Для этого примера требуется ровно один найденный контейнер; пустой результат или несколько строк означают, что схема проекта отличается и командный фрагмент надо адаптировать. Переменная ниже относится только к проверяемому сервису, поэтому последующие действия нельзя случайно распространить на все проекты хоста.
Ограниченный просмотр даёт мне пример сообщения и временные метки, не затапливая терминал всей историей. Параметры --since, --tail и --timestamps документированы в Docker container logs. Двести строк — только выборка для чтения. По ней нельзя честно вычислить полный суточный поток: при насыщенном журнале большая часть десятиминутного интервала просто не попадёт в вывод.
Я группирую повторения по смыслу: отладочная детализация, повторная попытка подключения, проверка здоровья, трассировка исключения, многословный access log. Для каждой группы задаю практический вопрос: сообщение отражает полезное событие или следствие неработающего механизма? Если приложение бесконечно пытается подключиться к недоступной зависимости, ограничение журнала защищает диск, но исправление зависимости остаётся отдельной обязательной задачей.
Вывод поля LogConfig показывает настройку конкретного контейнера. В моей карточке диагностики рядом стоят сервис, ID, образ, драйвер, параметры ротации, время наблюдения и основание связи с ростом. Наличие пустого списка опций я интерпретирую с учётом драйвера. У разных драйверов разные значения по умолчанию, и одинаково пустой объект ещё не означает одинаковый риск.
Чтобы уточнить распределение занятого места без чтения содержимого журналов, для проверенного json-file я могу получить путь через inspect и выполнить учёт блоков его родительского каталога. Это разовый административный просмотр метаданных на хосте Engine. Для другого драйвера или удалённого context фрагмент не применяю. При недостаточных правах передаю проверку администратору, не расширяя доступ агента.
log_file_path=$(docker inspect --format '{{.LogPath}}' "$container_id")
if [ -n "$log_file_path" ] && [ -f "$log_file_path" ]; then
  log_container_dir=$(dirname -- "$log_file_path")
  date -u +%FT%TZ
  du -sx --block-size=1 -- "$log_container_dir"
else
  echo 'Путь недоступен; учёт размера не выполнен.' >&2
fi
Результат относится ко всему родительскому каталогу, включая сопутствующие файлы контейнера, и не является точным счётчиком полезных сообщений. Повторное измерение через выбранный вручную интервал помогает сопоставить прирост с журналированием. Я не складываю вложенные результаты обхода с уже учтённым родительским каталогом: так возникает двойной счёт. Учёт выделенных блоков также отличается от длины текстового вывода, поэтому единицы и метод измерения сохраняю рядом с результатом.
Для причинного вывода мне нужны совпадение времени роста, активный поток повторений и отсутствие другого объяснения в проверяемом каталоге. Если безопасное снижение детализации уменьшает темп расхода при сопоставимой нагрузке, это дополнительный аргумент, но не контролируемый лабораторный эксперимент. Изменившийся трафик или фоновые задания могут повлиять на результат. Поэтому я описываю вывод как подтверждённую совокупностью признаков рабочую причину, а не как точную оценку вклада каждой строки.
Отдельно отмечаю срок полезности сохранённых свидетельств. Если журнал быстро вытесняется, дежурному нужен понятный порядок: заметить событие, зафиксировать время, получить ограниченную выборку, проверить внешнее хранилище. Без такого порядка даже технически исправная ротация может уничтожить нужный контекст раньше начала расследования. В моём плане работ защита диска и доступность диагностической истории проверяются раздельно, с разными критериями.
В рассматриваемом json-file Docker сохраняет stdout и stderr контейнера с временными метками. Для этого драйвера max-size по умолчанию не ограничивает размер; max-file имеет смысл вместе с заданным max-size. Файлы драйвера предназначены для управления daemon, поэтому внешнее изменение может нарушить работу журналирования. Эти свойства и ограничения приведены в документации json-file.
Из этого я делаю эксплуатационный вывод: нельзя считать произвольный файл /var/log/application.log внутри контейнера автоматически охваченным настройкой Docker. На схеме хранения я рисую две ветви. Первая — вывод процесса в stdout/stderr и выбранный logging driver. Вторая — файловый журнал приложения и его том или записываемый слой. У каждой ветви должен быть свой владелец и свой способ управления сроком хранения.
Ещё я проверяю внешнего потребителя. Если сборщик читает JSON-файлы по определённым путям, смена драйвера становится изменением интерфейса между системами. Совместимость этого сборщика нельзя вывести из того, что docker logs продолжает работать. Нужна отдельная проверка доставки сообщения, его меток и привязки к сервису после появления нового container ID. Иногда минимальное изменение — оставить существующий формат и включить ограничение объёма.
Драйвер local полезен как альтернатива: он использует внутренний формат, автоматически ротирует и по умолчанию сжимает журналы. Документированный стандартный бюджет основан на пяти файлах по 20 MB, до учёта эффекта сжатия. Я не выдаю это за точное физическое потребление диска. Свойства и опции опубликованы в документации local.
6. Считаю бюджет и отдельно выбираю срок расследования
Я начинаю с двух вопросов: сколько места можно отдать журналам на этом хосте и за какой интервал дежурный должен успеть получить сведения об ошибке. Лимит по объёму не равен гарантированному сроку хранения. При росте числа сообщений тот же бюджет сохранит более короткую историю. Поэтому требование «нужны журналы за вчера» я не перевожу напрямую в случайное значение max-size.
Учебный расчёт: при двадцати контейнерах и настройке три файла по десять мегабайт номинальный совокупный бюджет составляет около шестисот мегабайт. Это арифметическая оценка по выбранным параметрам, не измерение и не жёсткая квота на файловую систему. Я отдельно оставляю запас на метаданные, операции чтения, другие данные, новые реплики и допустимые отклонения реальной реализации. Экономию от сжатия заранее в гарантированный резерв не включаю.
Для оценки глубины истории я беру измеренный полный поток байтов за репрезентативный интервал из разрешённого средства наблюдения. Деление доступного бюджета на скорость даёт ориентир времени до вытеснения старых записей. Дежурные должны понимать его ограничения: всплеск ошибок, изменение уровня логирования и новый релиз могут резко изменить скорость. В карточке сервиса я сохраняю не только число, но и период наблюдения, характер нагрузки и способ подсчёта.
Практический выбор для пилота — сохранить json-file и назначить явные max-size: "10m", max-file: "3". Это небольшие учебные параметры для проверки механизма; для рабочего сервиса их выбирают по требованиям хранения. Если обязательная история не помещается локально, проектируется внешнее хранение с проверкой доставки. Увеличение лимита без расчёта суммарного потребления переносит проблему на следующий пик нагрузки.
7. Сначала обеспечиваю запас для безопасной работы
Если раздел почти заполнен, я не начинаю с создания большого архива на нём же. Нужные фрагменты журналов сохраняю в заранее разрешённое хранилище с проверенным запасом и ограниченным доступом. Записываю интервал, исходный container ID и назначение выгрузки, проверяю, что результат читается. Секреты и персональные сведения удаляются из копии для обсуждения, а доступ к исходному доказательству определяется внутренними правилами организации.
Для срочного уменьшения потока я предпочитаю документированное снижение избыточной детализации приложения или управляемую паузу источника шума, если владелец подтвердил последствия. Эти действия зависят от приложения, поэтому универсальную команду выключения логов не предлагаю. Когда свободного места недостаточно для контролируемого пересоздания, сначала требуется увеличение ёмкости либо отдельная согласованная очистка точно идентифицированных ненужных данных.
В эту процедуру я не включаю массовый prune, удаление Docker-каталогов и обнуление активного файла журнала. Они не доказывают правильность будущей ротации. Перед переходом дальше у меня должны быть сохранены необходимые свидетельства, установлен источник роста и обеспечен рабочий запас. Если хотя бы одно условие не выполнено, я продолжаю локализацию и стабилизацию, а не маскирую незавершённую диагностику успешным освобождением нескольких гигабайт.
8. Готовлю изменение одного сервиса и проверяю данные
До редактирования я сохраняю исходный Compose-файл и значения, нужные для сравнения. В примере создаётся закрытый каталог внутри текущего проекта. Если этот раздел заполнен, вместо него заранее выбирается разрешённый каталог на другом разделе. Сохранённый YAML может содержать чувствительную конфигурацию: его не коммитят автоматически и не пересылают вместе с отчётом.
Вручную сверяю назначения mount с документацией приложения. Если база, загрузки или другая нужная информация оказались только в записываемом слое контейнера, пересоздание откладываю до корректного переноса и проверки копии. Сохранённый список mount не является резервной копией данных. Для stateful-приложения у меня отдельно должны быть известны процедура согласованного резервирования, результат проверки восстановления и допустимая потеря последних изменений.
В действующий сервис web добавляю следующий фрагмент, сохраняя остальные его поля. Это не полный Compose-файл для нового приложения. Я не заменяю образ, порты, сети, healthcheck, тома или параметры запуска одновременно с настройкой журналов: иначе результат пилота будет трудно связать с конкретным изменением.
Затем проверяю модель, которую Compose действительно построит. config объединяет указанные файлы и разрешает переменные; режим --quiet проверяет конфигурацию без печати. Для осмотра только нужной части использую фильтр, оставляя полный результат вне терминала. Поведение этих режимов описано в Docker compose config.
Проверка синтаксиса — ещё не разрешение на запуск. Я отдельно сверяю, что выбранный образ локально доступен и соответствует текущему image ID, конфигурация mount сохранена, а entrypoint и предусмотренные проектом hooks не выполнят нежелательное действие при старте. Любое чужое параллельное изменение Compose-файла нужно разобрать до продолжения.
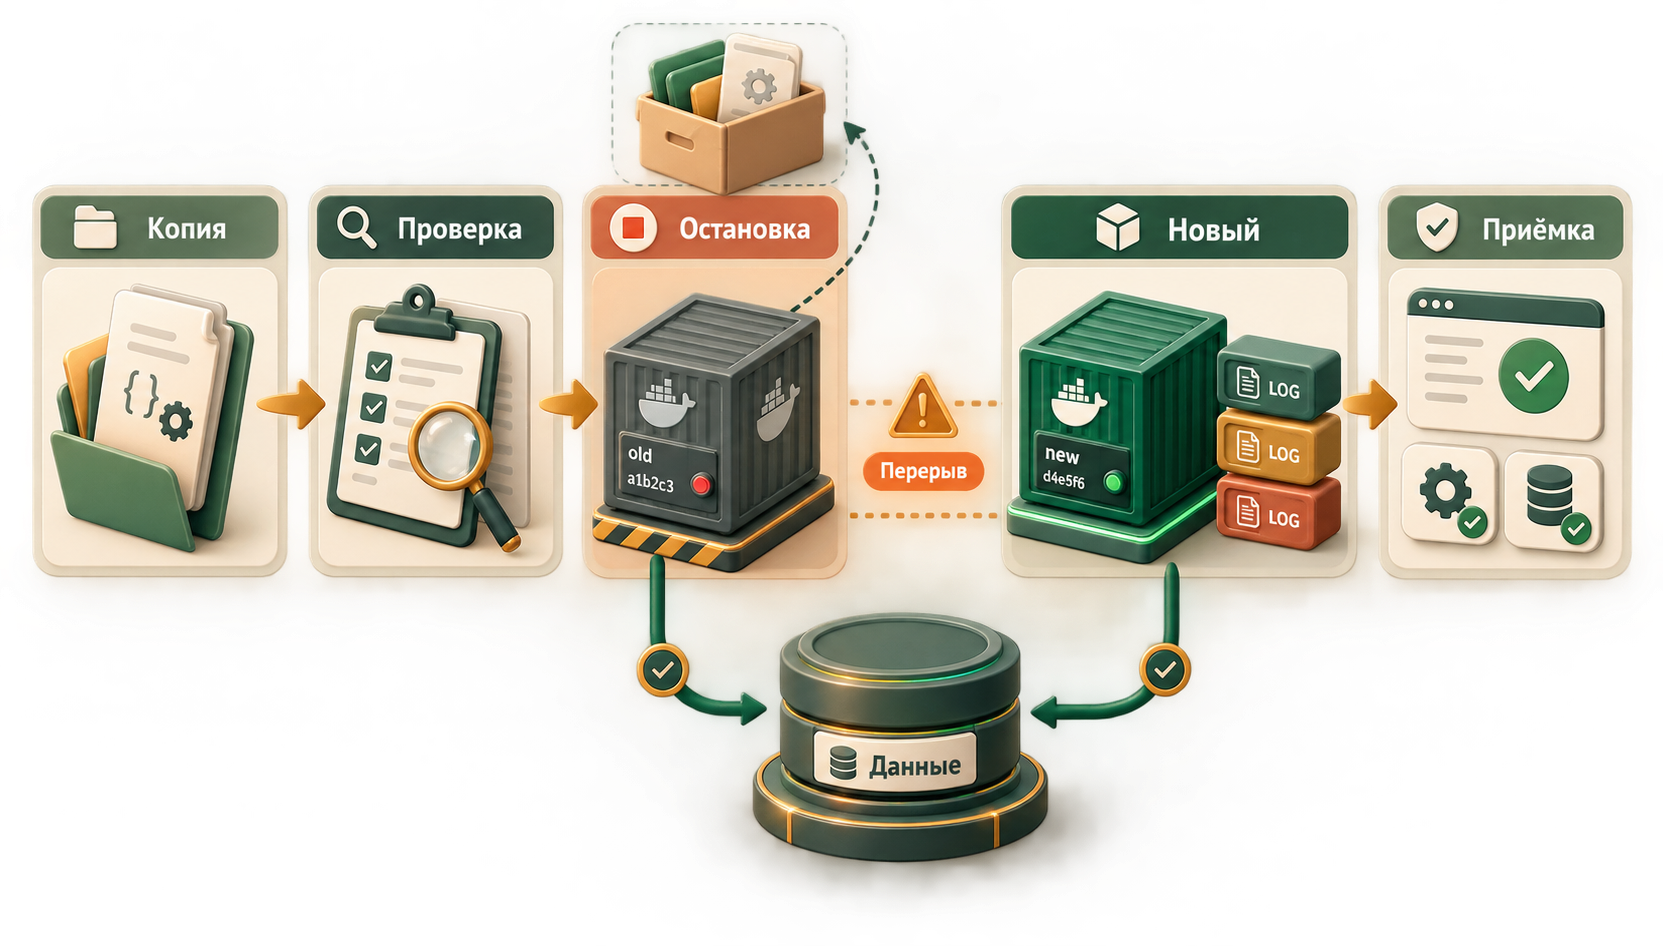
9. Пересоздаю контейнер в согласованное окно
Редактирование политики по умолчанию у daemon не обновляет существующие контейнеры. Для замены их настроек logging нужен recreate; обычный restart этой задачи не решает. Это явно указано в руководстве по настройке logging drivers. Поэтому в пилоте я оставляю глобальную конфигурацию Docker в стороне и работаю с явно выбранным сервисом.
Непосредственно перед выполнением снова проверяю проект и число экземпляров. Если выяснилось, что реплик несколько, данный вариант остановки не использую. При одной реплике сначала выполняю согласованный с владельцем порядок прекращения новых запросов и завершения активных операций. Сам по себе Compose не превращает такой сервис в отказоустойчивый и не доказывает, что очередь заданий обработана корректно.
Следующий фрагмент выполняется только после проверок предыдущего раздела. Если проверка конфигурации завершилась с ошибкой, пересоздание не запускается. Бюджет ожидания в сто двадцать секунд — учебное допущение, его заменяют согласованным временем запуска приложения. Наличие healthcheck делает ожидание содержательнее, но даже корректный healthcheck не заменяет пользовательскую проверку.
if docker compose -f compose.yaml config --quiet; then
  docker compose -f compose.yaml up -d --no-deps --force-recreate \
    --no-build --pull never --wait --wait-timeout 120 web
else
  echo 'Конфигурация не прошла проверку; изменение остановлено.' >&2
fi
IT Fresh
Настройки проверяю у нового контейнера. Том, пользовательский путь и внешнюю доставку логов проверяю отдельно; одна реплика допускает перерыв.
Команда ограничивает выбор сервисом web, не запускает его зависимости, запрещает сборку и получение образа из registry. up при пересоздании сохраняет подключённые тома; --wait ожидает состояние running или healthy. Эти свойства документированы в Docker compose up. Я всё равно проверяю конкретные mount и данные: сохранение подключённых томов не означает сохранение произвольного файла из старого контейнера.
Любой ненулевой код завершения считаю незавершённым изменением. Не запускаю подряд повторные recreate, не разобрав, контейнер не создан, не стартовал или не прошёл ожидание. Сначала фиксирую состояние выбранного сервиса и ограниченную диагностическую выборку. Причина может находиться в приложении, правах тома или его стартовой процедуре, а не в самом механизме журналирования.
10. Проверяю результат по новым идентификаторам
После запуска я заново получаю ID. Старое значение переменной больше не подходит для доказательства текущей конфигурации. Сравниваю фактический драйвер и лимиты, image ID и список подключений. Изменившийся ID контейнера ожидаем; неожиданно изменившийся образ или источник постоянных данных требует остановить приёмку и выяснить причину.
Далее я выполняю согласованное безопасное действие через обычный пользовательский путь: например, чтение тестовой страницы или получение заранее известного объекта без изменения бизнес-данных. Проверяю не только код ответа, но и ожидаемое содержимое. При наличии внешнего сборщика нахожу относящееся к действию сообщение и удостоверяюсь, что оно связано с правильным сервисом после смены ID.
Новые параметры в inspect подтверждают применение конфигурации, но ещё не наблюдавшуюся ротацию. Для доказательства оборота журналов я использую отдельный тестовый сервис с уменьшенным лимитом, разрешённым локальным образом и конечным заранее ограниченным объёмом сообщений. В нём нет рабочих томов и пользовательского трафика. Бесконечный генератор в production для такой проверки не нужен. На стенде сверяются сохранность последних записей, вытеснение старых и стабилизация занятого места после нескольких циклов.
На рабочем сервисе затем наблюдаю нормальную нагрузку в согласованном интервале, включая характерный период активности. Если за это время порог не достигнут, пишу в приёмке прямо: параметры применены, оборот на рабочем потоке пока не наблюдался. Одно уменьшение занятого пространства после удаления старого контейнера не выдаю за долговременную проверку новой политики.
11. Настраиваю сигналы так, чтобы они объясняли риск
Для мониторинга я различаю нехватку места, риск потери нужной истории и отсутствие наблюдения. У этих событий разные действия дежурного. Первое требует оценить запас и скорость расхода, второе — проверить бюджет журналов и внешнее хранение, третье — восстановить сбор. Если один общий триггер скрывает различия, его полезность быстро падает.
В Zabbix я предлагаю собирать свободные байты и процент, свободные inode и время последнего успешного получения агрегатов. Это требования к проектированию мониторинга, а не готовый импортируемый шаблон для неопределённой версии Zabbix. Проверку соответствия logging-политике я связываю с постоянным именем проекта и сервиса, а container ID сохраняю как изменяемый атрибут. Тогда штатный recreate не превращается в бесконечное появление новых несвязанных объектов.
Порог запаса выбираю по времени реакции команды и темпу расхода, а не только по привычному проценту. Пример логики: предупреждение появляется при устойчивом сокращении запаса на нескольких последовательных измерениях; отдельная срочная ветка реагирует на согласованный абсолютный минимум. Окно усреднения нельзя делать настолько длинным, чтобы оно скрывало быстрое заполнение. Для восстановления использую больший запас или подтверждение нескольких успешных проверок, чтобы событие не переключалось на каждой ротации.
Я отдельно учитываю ложные тревоги. Пилообразный график при штатном обороте журналов отличается от непрерывного роста. Изменение числа реплик меняет суммарный бюджет. Плановый импорт, архивирование или другой сервис на том же разделе меняют свободное место без связи с проверяемым журналом. После каждого такого объяснения нужен подтверждающий признак; слово «планово» само по себе не основание закрыть проблему.
Ложное спокойствие опаснее лишнего предупреждения: переставший присылать данные сборщик не должен выглядеть как нулевой поток логов. Сохраняю отдельную метку свежести, различаю ноль и неизвестное значение, проверяю доставку контрольного события. Временное обслуживание ограничиваю действительно затронутым сервисом; наблюдение за диском продолжается, пока контейнер пересоздаётся.
12. Делаю откат конкретным и проверяемым
Основания для отката я записываю до изменения: приложение не проходит согласованную проверку, внешний сборщик потерял поток, новая конфигурация не принимается либо данные подключились не к тому источнику. Если причина в неправильном mount, сначала прекращаю опасные записи по процедуре приложения. Автоматическое возвращение трафика в таком состоянии может осложнить восстановление.
При условии, что после сохранения копии никто не менял Compose-файл параллельно, возвращаю его исходное содержимое в исходный путь. Это сохраняет базу разрешения относительных путей. Запуск сохранённого файла прямо из подкаталога без проверки путей я не использую. Для многокомпонентного проекта восстановлению подлежит весь согласованный набор файлов и параметров, а не только один удобный YAML.
if cp -p -- "$change_dir/compose.before.yaml" compose.yaml; then
  if docker compose -f compose.yaml config --quiet; then
    docker compose -f compose.yaml up -d --no-deps --force-recreate \
      --no-build --pull never --wait --wait-timeout 120 web
  else
    echo 'Возвращённая конфигурация не прошла проверку.' >&2
  fi
else
  echo 'Не удалось вернуть исходный файл; запуск остановлен.' >&2
fi
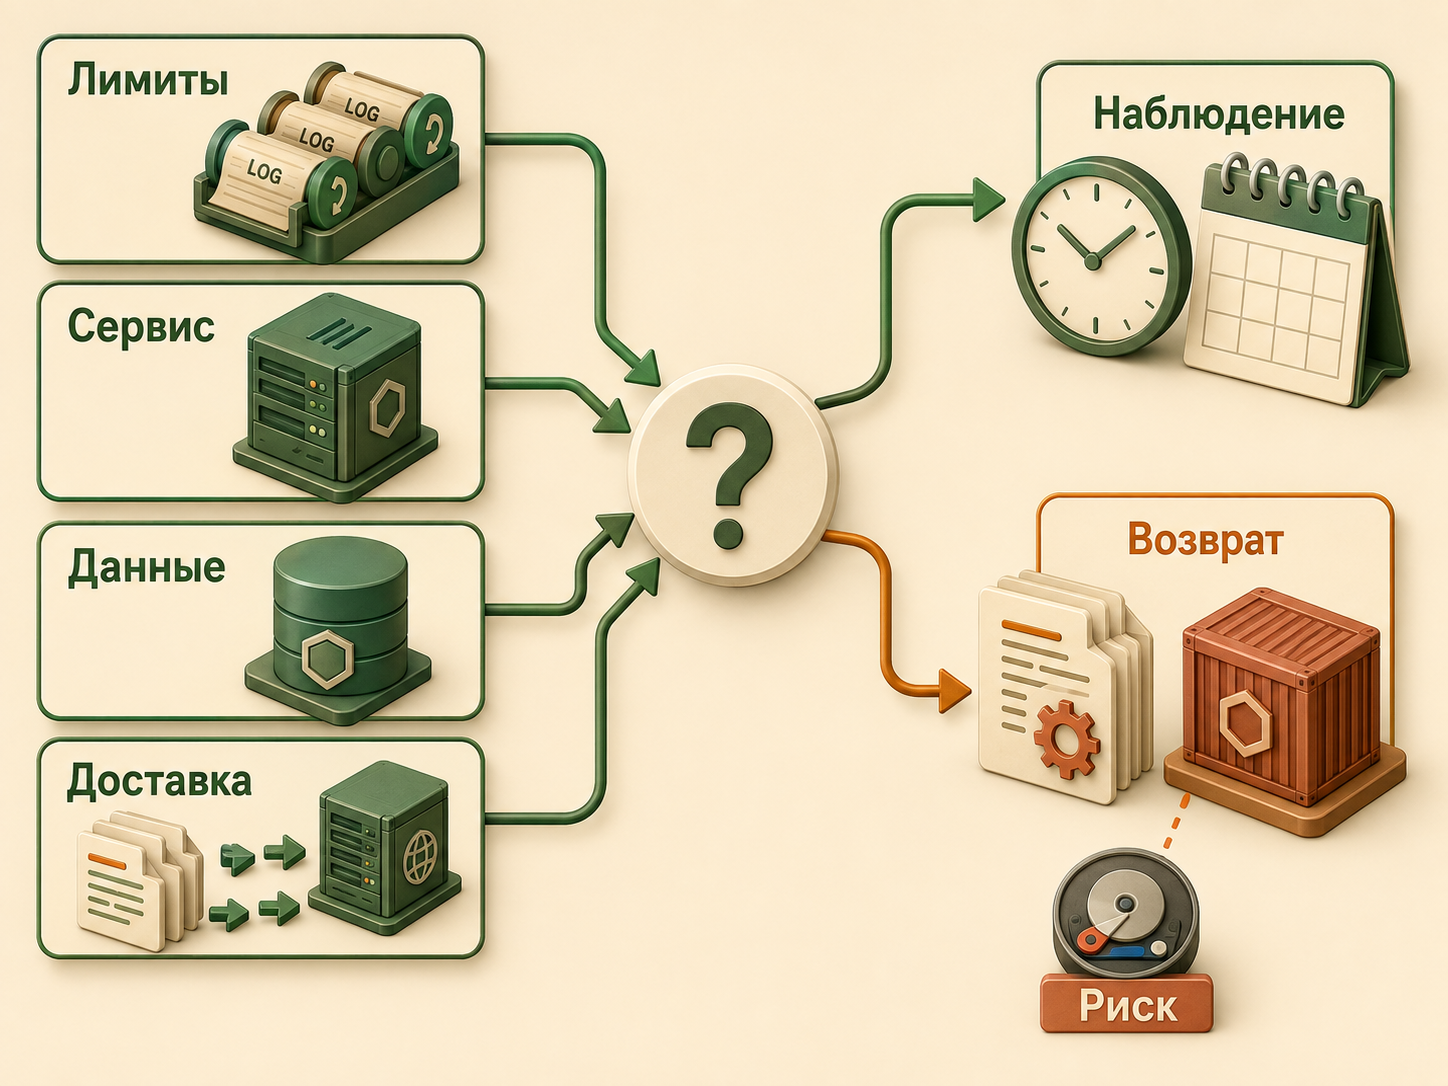
После отката повторяю проверку образа, mount, пользовательского действия и доставки логов. Возврат YAML не восстанавливает журналы удалённого контейнера и не отменяет изменения, которые приложение успело записать в данные. Именно поэтому свидетельства сохраняются заранее, а изменения схемы данных и обновление версии приложения исключаются из этой операции.
Если исходная конфигурация оставляла логи без ограничения, откат возвращает и прежний риск роста. Я фиксирую временную меру стабилизации, ответственного и срок следующего исправления. Наличие свободного места на момент отката не позволяет закрыть задачу как решённую. Успешный откат означает восстановление согласованного рабочего состояния с известными ограничениями.
IT Fresh
Применённые лимиты — один из критериев. При откате повторяю проверки и сохраняю открытым риск, если исходная политика не ограничивала логи.
13. Закрываю работу по доказательствам
Для приёмки мне нужен небольшой проверяемый пакет: точные версии и контекст, старый и новый ID, одинаковый ожидаемый образ, согласованные mount, фактический LogConfig, результат пользовательской проверки и наблюдение за диском. Секретов в этом пакете быть не должно. Владелец сервиса должен понимать, где теперь находится нужная история и сколько времени остаётся на её извлечение при увеличении потока.
Работу считаю законченной, когда установлена причина роста, нужные данные сохранены, параметры действуют, приложение работает и мониторинг различает нехватку места и пропажу сведений. Проверка механизма ротации должна иметь отдельный результат либо явно открытый пункт наблюдения. Неизвестная совместимость сборщика, непройденное восстановление данных или неподтверждённый срок хранения остаются открытыми вопросами с владельцем, а не исчезают из отчёта.
После успешного пилота применяю политику к остальным сервисам по очереди, учитывая их поток и время остановки. Глобальные значения по умолчанию можно стандартизировать отдельным изменением, но инвентаризация уже созданных контейнеров всё равно нужна. В документации сервиса оставляю бюджет, способ доставки, права доступа, действия при заполнении и шаги отката. Так следующему дежурному не придётся заново угадывать, какой файл допустимо трогать.
Полезные вопросы
Можно ли включить non-blocking, чтобы медленное журналирование не задерживало приложение?
Это отдельный компромисс: Docker использует промежуточный буфер, а при его заполнении новые сообщения отбрасываются. Я принимаю такое решение вместе с владельцем требований к журналам, отдельно от ротации файлов. Режим и последствия описаны в разделе о доставке сообщений logging driver. Увеличение буфера не заменяет управление дисковым бюджетом.
Нужно ли хранить все отладочные сообщения для расследований?
Я согласовываю перечень событий, необходимых для конкретного расследования, и временное включение детализации с датой отключения. Бесконтрольная отладка может вытеснить полезные записи быстрее обычного потока. Если требуется продолжительная история, для неё заранее выделяются отдельное хранилище, доступ и проверка доставки, а локальная ротация остаётся защитой хоста.
Если вы не можете установить источник заполнения, безопасно применить ротацию или подтвердить работу приложения после изменения, свяжитесь со мной. Начать разбор можно с обезличенного описания среды, симптомов и уже выполненных проверок. Пароли, токены и полные рабочие журналы в первое сообщение присылать не нужно.